모든 태그

# 추천 서빙

3개의 글

과부하에서 무엇을 포기하나: 정책은 지연을 정하고 개인화 비율은 모델 용량이 정한다

추천 모델이 감당하는 양보다 요청이 많을 때 넘친 요청을 어떻게 포기할지 세 정책을 비교했다. 개인화를 받은 요청 비율(coverage)은 세 정책이 ±0.3%p 안에서 같았고 갈린 것은 p95(160ms·320ms·454ms)였다. 아무것도 거절하지 않는 정책은 4배 부하에서 coverage가 31.4%로 더 좋아 보였는데 요청을 받지도 못해 분모에서 빠진 생존자 편향이었다.
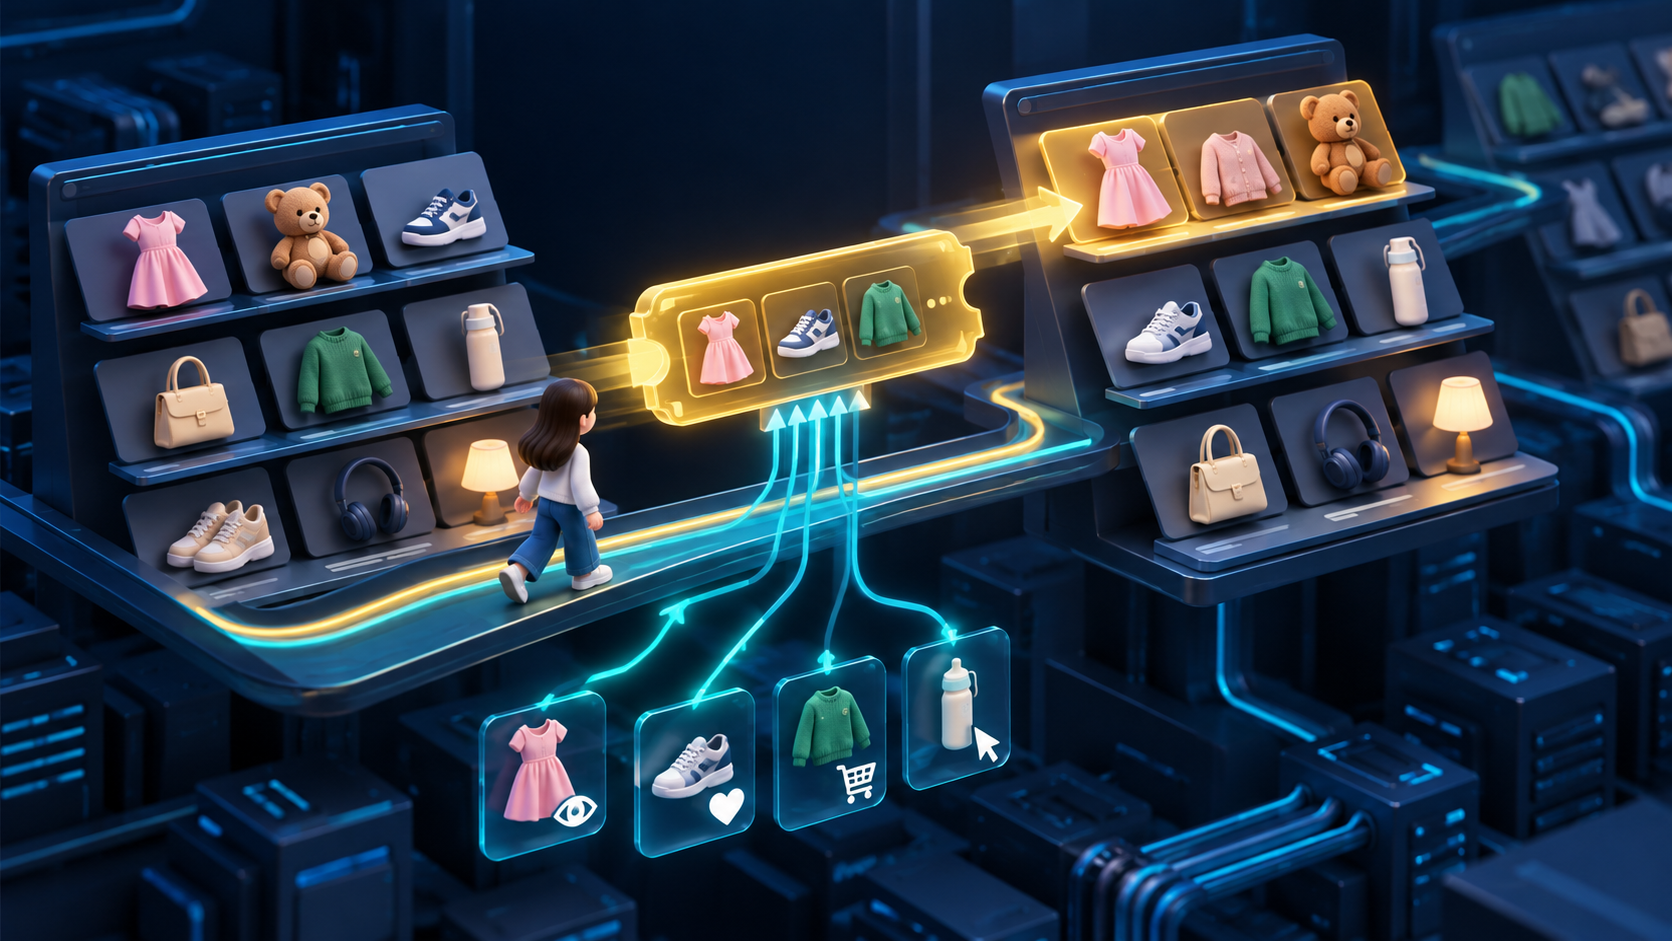
홈을 여러 쪽으로 나눠 만들었다: 커서가 보여 준 것을 들고 다니고, 다음 쪽 순서는 방금 본 상품이 정한다

GenPage처럼 홈을 몇 행씩 나눠 만들고 다음 쪽이 앞 쪽과 그 사이의 세션 활동을 입력으로 받게 했다. 쪽 상태는 서버에 두지 않고 커서에 실었다. 사용자 30명 실측에서 쪽 사이 중복은 0(커서가 없으면 2쪽 평균 8.6개)이었고 세션 반영은 96.7~100%였다. 1차에서는 인기 표에 아동복이 0개라 세션 신호가 조용히 버려지고 있었다.

GenPage를 실제 홈에 붙여 보니 모델보다 입력과 과부하 계약이 먼저 흔들렸다

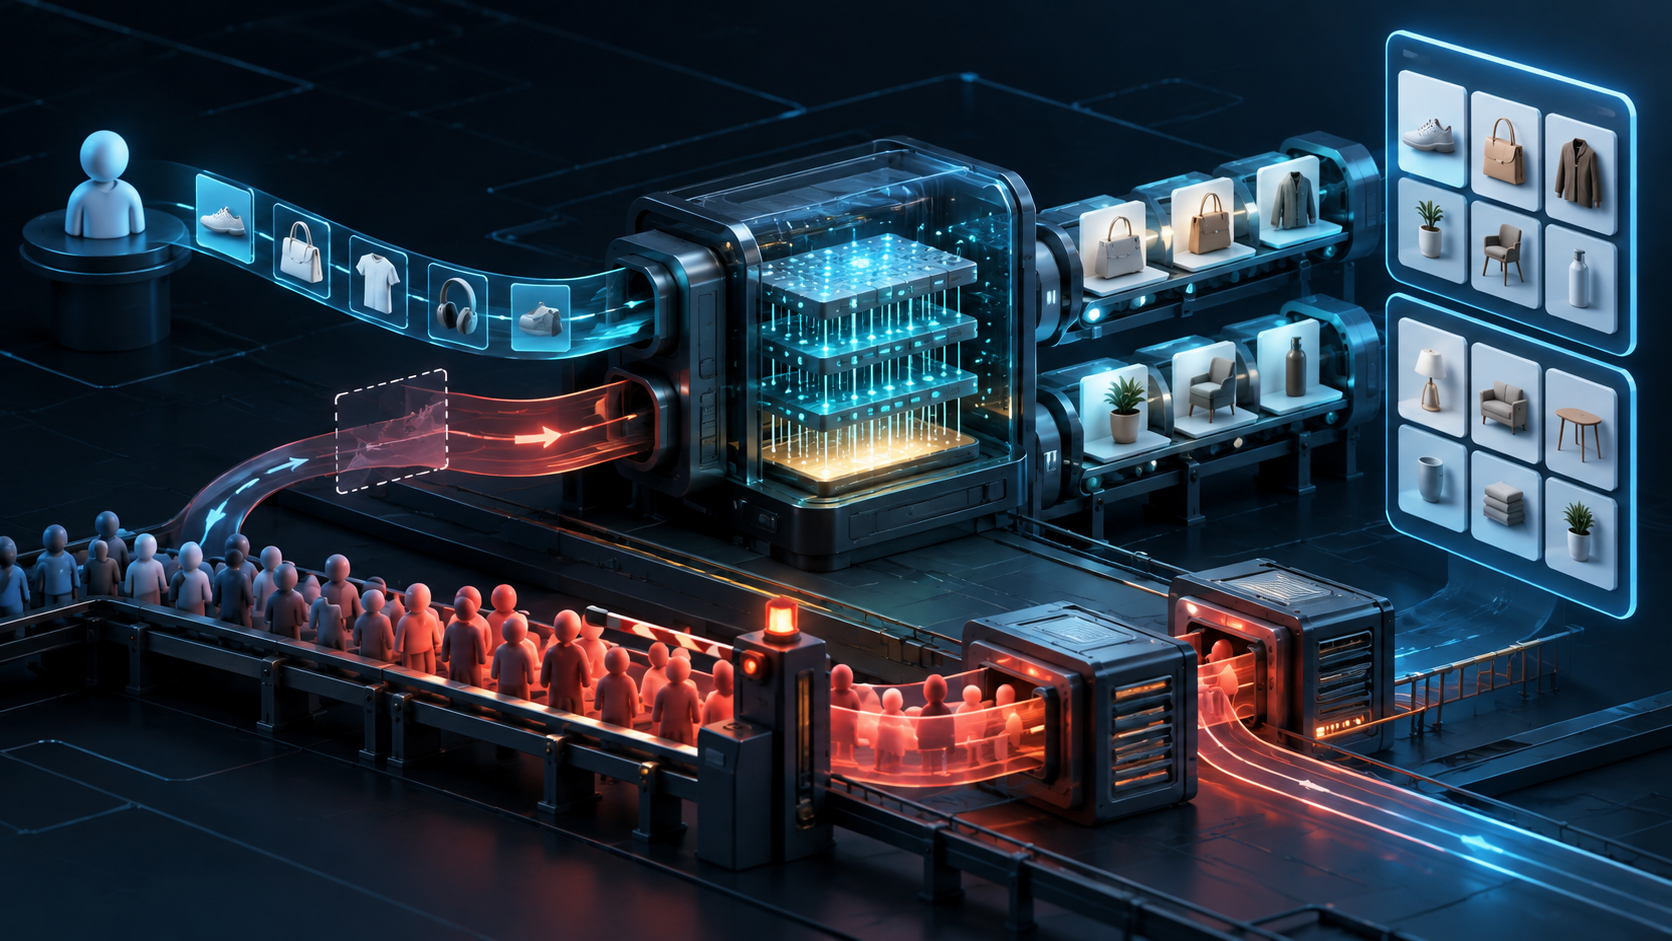
사용자 이력으로 홈 2쪽을 생성하는 작은 GenPage 모델을 만들고 실제 서빙 경로까지 연결했다. 모델 품질은 MAP@12 0.0209로 기준선 0.0234를 넘지 못했지만, 더 큰 문제는 빈 HTTP 본문·학습과 다른 입력·게이트 밖 2쪽 호출이었다. 네 실험을 한 흐름으로 묶어 무엇을 확인하고 기본값을 켜지 않았는지 정리한다.