소개
안녕하세요. 범수입니다.
개발을 잘하고 싶고, 제가 만든 프로그램이나 코드가 누군가에게 도움이 되었으면 좋겠습니다.
언젠가는 제가 배운 것들을 블로그나 유튜브로 다른 사람들과 나누고 싶고, 계속 재미있는 프로젝트도 만들고 싶습니다. 누군가가 저를 보면서 "나도 저렇게 되고 싶다"고 생각해 준다면 정말 좋을 것 같습니다.
그리고 개발을 떠나서는 좋은 사람들과 행복하게 살고 싶습니다.
사랑하는 사람과 결혼도 하고 싶고, 멋진 사회인도 되고 싶고, 먼 훗날 돌아봤을 때 "그래도 인생 잘 살았다"라는 자부심을 가지고 싶습니다.
그게 제 꿈입니다.
아직은 취업을 준비하며 이것저것 공부하고 있습니다.
그런데 요즘 공부를 하면서 한 가지 고민이 생겼습니다.
AI가 이렇게 빠르게 발전하는 시대에 나는 무엇을 공부해야 할까?
예전에는 직접 구현할 수 있다는 것 자체가 중요했습니다.
조회가 많으면 캐시를 붙이고, 요청을 바로 처리하기 어렵다면 큐를 두는 것처럼 많은 문제에는 이미 잘 알려진 해결 방법이 있습니다.
예전에는 이런 걸 알고 직접 구현하는 능력 자체가 중요했습니다. 결국 사람이 키보드로 하나하나 만들어야 했으니까요.
그런데 요즘은 조금 다릅니다.
문제를 잘 설명하고 필요한 맥락을 충분히 주면 AI가 이런 코드들을 굉장히 빠르게 만들어냅니다.
제가 며칠 동안 만든 것도 개발을 잘 아는 사람이 AI 에이전트 여러 개를 잘 활용하면 비슷하게 만들어낼 수 있습니다.
이미 그런 시대가 된 것 같습니다.
그래서 프로젝트를 하다가 문득 이런 생각이 들었습니다.
"기능을 구현하고, 써보고, 개선하는 것만 반복하면 앞으로도 나를 필요로 할까?"
조금 무서운 질문이었습니다.
그래서 요즘은 AI가 쉽게 답을 만들어주는 문제보다 정답이 쉽게 나오지 않는 문제에 더 관심을 가지려고 합니다.
캐시를 구현하는 방법보다 여기서 정말 캐시를 쓰는 게 맞는지, 메시지 큐를 붙이는 방법보다 굳이 지금 큐가 필요한지, 성능과 안정성이 충돌한다면 어디까지 포기할 수 있는지 같은 질문들입니다.
결국 이런 판단을 하려면 기본기가 필요하다고 생각했습니다.
운영체제, 네트워크, 데이터베이스 같은 CS를 공부하는 이유도 여기에 있습니다.
AI가 답을 알려줘도 그 답이 맞는지 판단하는 건 결국 사람의 몫이니까요.
그래서 요즘 제가 중요하게 생각하는 건 크게 몇 가지입니다.
첫 번째는 기반 지식입니다.
유행하는 기술을 하나 더 아는 것보다 컴퓨터가 왜 이렇게 동작하는지를 이해하고 싶습니다.
두 번째는 트레이드오프를 판단하는 능력입니다.
무엇을 사용했는지보다 왜 그것을 선택했고, 그 선택 때문에 무엇을 얻고 무엇을 포기했는지를 고민하려고 합니다.
세 번째는 사람들과 이야기하는 능력입니다.
개발은 결국 혼자 하는 일이 아니니까요. 내가 무엇을 하고 있는지, 왜 이렇게 생각했는지, 어디에서 막혔는지를 다른 사람에게 잘 전달하는 것도 개발만큼 중요하다고 생각합니다.
그리고 네 번째는 조금 역설적이지만 AI를 잘 사용하는 능력입니다.
AI가 잘하는 일을 굳이 제가 더 느리게 할 필요는 없다고 생각합니다.
반복적인 구현은 AI에게 맡길 수 있습니다. 대신 무엇을 만들어야 하는지 정하고, 결과가 맞는지 검증하고, 잘못된 방향으로 가고 있다면 멈추게 하는 능력이 더 중요해질 것 같습니다.
일하는 방식도 연습하고 있습니다.
개인 프로젝트니까 생각나는 대로 만들어도 되지만, 일부러 일을 나눠보고 예상 시간도 잡아보고 완료 조건도 정해봅니다.
전체 작업 → 큰 작업 → 세부 작업 → 예상 시간 → 완료 조건 → 실제 결과
예상은 자주 틀립니다.
그래도 예상하고, 실제로 해보고, 왜 달랐는지 다시 보는 일을 반복하다 보면 언젠가는 일을 좀 더 잘하는 사람이 되지 않을까 생각합니다.
그래서 이 블로그에는 제가 공부하고 삽질하고 고민한 것들을 기록하려고 합니다.
CS를 공부하다가 이제야 이해한 것, 프로젝트를 만들다가 터뜨린 것, 성능을 재봤더니 예상과 전혀 달랐던 것, AI를 개발에 써보다가 발견한 것, 취업을 준비하면서 느낀 것까지 딱히 한 분야만 정해두지는 않으려고 합니다.
지금은 아직 취업도 준비하고 있고, 모르는 것도 정말 많습니다.
그래서 오히려 지금부터 기록해두고 싶습니다.
몇 년 뒤 이 블로그의 첫 글들을 다시 봤을 때
"와, 이때는 이런 것도 몰랐네."
하면서 웃을 수 있었으면 좋겠습니다.
그리고 그때쯤에는 지금 제가 꿈꾸는 모습에 조금은 가까워져 있었으면 좋겠습니다.
그 과정에서 제가 남긴 글 하나가 누군가의 문제를 해결하는 데 도움이 된다면 더 좋고요.
그렇게 하나씩 기록해보겠습니다.
잘 부탁드립니다.
이력
학력
-
원광대학교 컴퓨터소프트웨어공학과
2019.03 ~ 2025.02- 기업연계프로젝트 1·2를 두 학기 연속 팀으로 수행하고 모두 최고 학점으로 마쳤습니다.
교육
-
삼성청년SW아카데미(SSAFY) 13기
2025.01 ~ 2025.12 -
AWS 모던 애플리케이션 교육
2023.12
개인 프로젝트
- 2026.09 ~ 진행 중
- 요청을 말하면 에이전트가 코드를 쓰고 격리된 샌드박스에서 실제로 실행합니다. 체크포인트마다 파일과 DB 상태를 함께 남깁니다.
- 2026.03 ~ 진행 중
- MySQL·PostgreSQL·Oracle·SQL Server·MongoDB를 한곳에서 모니터링하고 쿼리 이상과 성능 회귀를 찾습니다.
- 2026.02 ~ 2026.05
- 1,215만 건의 위키 문서를 Lucene으로 색인·검색하고, 캐시와 읽기·쓰기 분리로 트래픽을 처리합니다.
- 2025.10 ~ 진행 중
- 결제 승인·취소부터 원장·정산·대사·구독·분쟁까지 처리합니다.
- 2026.01 ~ 2026.08
- 게임 데이터를 스프레드시트처럼 편집하고 버전별 수치와 변경 이력을 관리합니다.
- 2026.03 ~ 진행 중
- IDE 안에서 코딩테스트 문제를 가져오고 실행·채점·제출까지 처리합니다. JetBrains Marketplace에 출시했습니다.
팀 프로젝트
-
별찌
2026.05 ~ 2026.07- 지금 보고 있는 상품을 기준으로 여러 쇼핑몰의 가격과 중고 대안을 한 화면에 모아 비교해 주는 AI 패션 쇼핑 어시스턴트입니다.
- 2025.10 ~ 2025.11
- C2C 대여 플랫폼에서 회원 시스템과 실시간 채팅 전체를 설계·구현했고, 담당자 이탈 후 결제 에스크로를 이어받았습니다.
- 2025.08 ~ 2025.09
- 음성 기반 노래 추천 플랫폼에서 파일 업로드, 앨범과 녹음 관리, 모니터링 인프라 전체를 맡았습니다.
- 2025.07 ~ 2025.08
- 청각장애 학습자용 실시간 자막 교육 플랫폼에서 게시판 API, S3 업로드 파이프라인, 단위 테스트 127개를 맡았습니다.
수상
- 2025.11
- C2C 대여 플랫폼 빌려조잉을 6인 팀으로 6주 동안 만들었고, 팀장과 백엔드를 맡았습니다.
- 2023.12
자격증
-
정보처리기사
2025.12 -
데이터분석준전문가(ADsP)
2024.11 -
SQL개발자(SQLD)
2024.08
오픈소스 기여
- 2026.02
- TestEntityManager에 타입을 인자로 넘기지 않아도 되는 Kotlin 확장 함수를 추가했습니다(find<Foo>(id) 등).
- 메인테이너 커밋으로 반영되어 4.1.0-M2 새 기능 목록에 기록되었습니다.
- 2026.02
- IndexWriter 초기화 실패 시 스레드 풀이 누수되던 문제를 실패 경로 정리로 수정했습니다.
- 메인 브랜치에 반영되고 CHANGES.txt에 버그 수정으로 기록되었습니다.

프로젝트
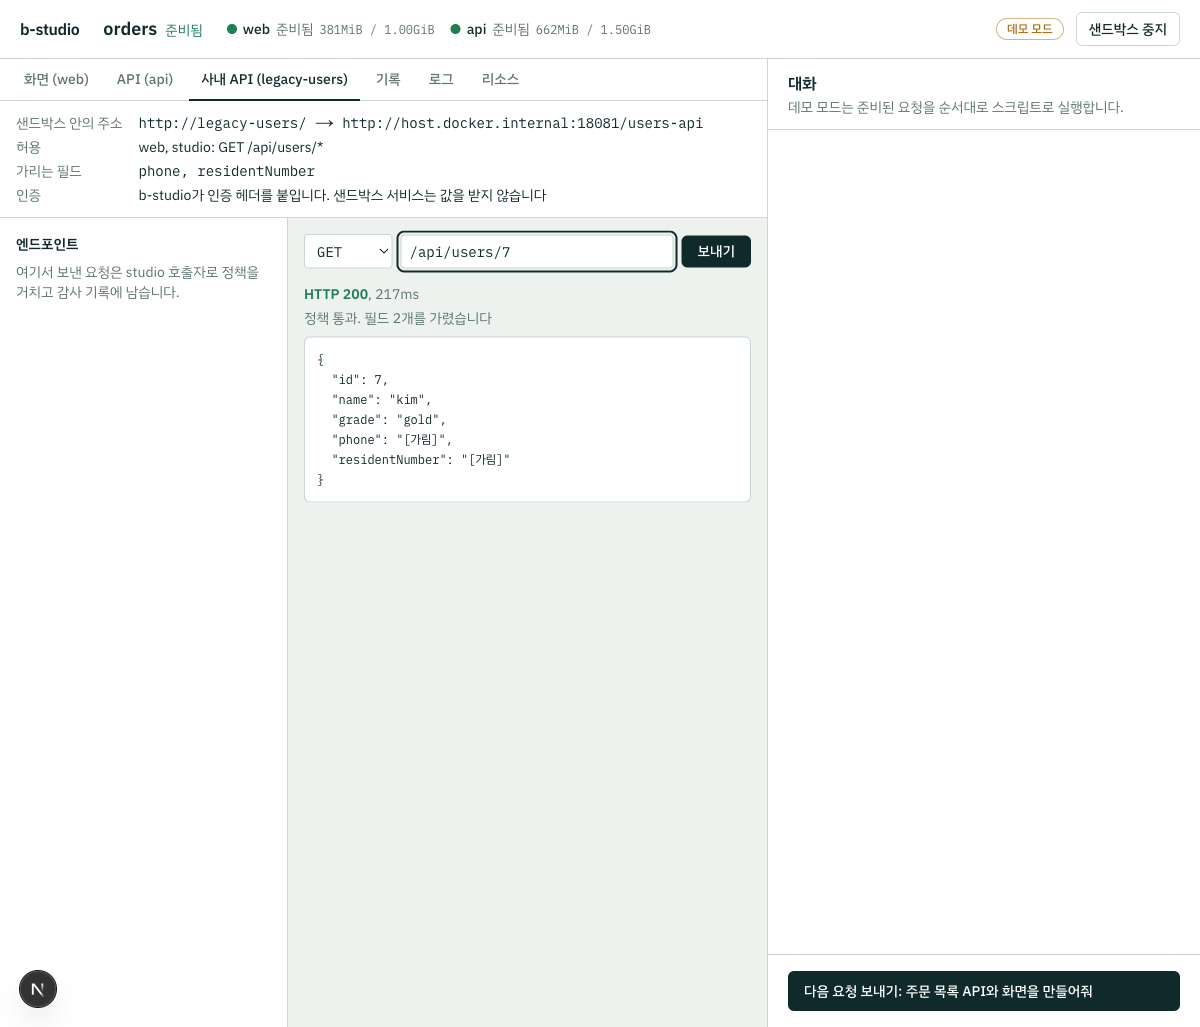
b-studio — 사내 도구를 만드는 AI 앱 빌더
요청을 말하면 에이전트가 코드를 쓰고, 그 코드를 격리된 샌드박스에서 실제로 실행합니다. 체크포인트마다 파일과 DB 상태를 함께 남기고, 샌드박스의 출입구를 edge 컨테이너 하나로 모아 허용 규칙과 감사 기록을 강제합니다.

dbtower-lakehouse — 버려지는 관측 데이터의 장기 분석 파이프라인
DBTower의 단기 관측 데이터를 장기 보관하고, 기간별 쿼리 성능 변화를 조회·분석하는 데이터 파이프라인입니다.

DBTower — 이기종 DBMS 운영 관리 플랫폼
MySQL·PostgreSQL·Oracle·SQL Server·MongoDB를 한곳에서 모니터링하고, 쿼리 이상과 성능 회귀를 비교·진단하는 데이터베이스 운영 플랫폼입니다.
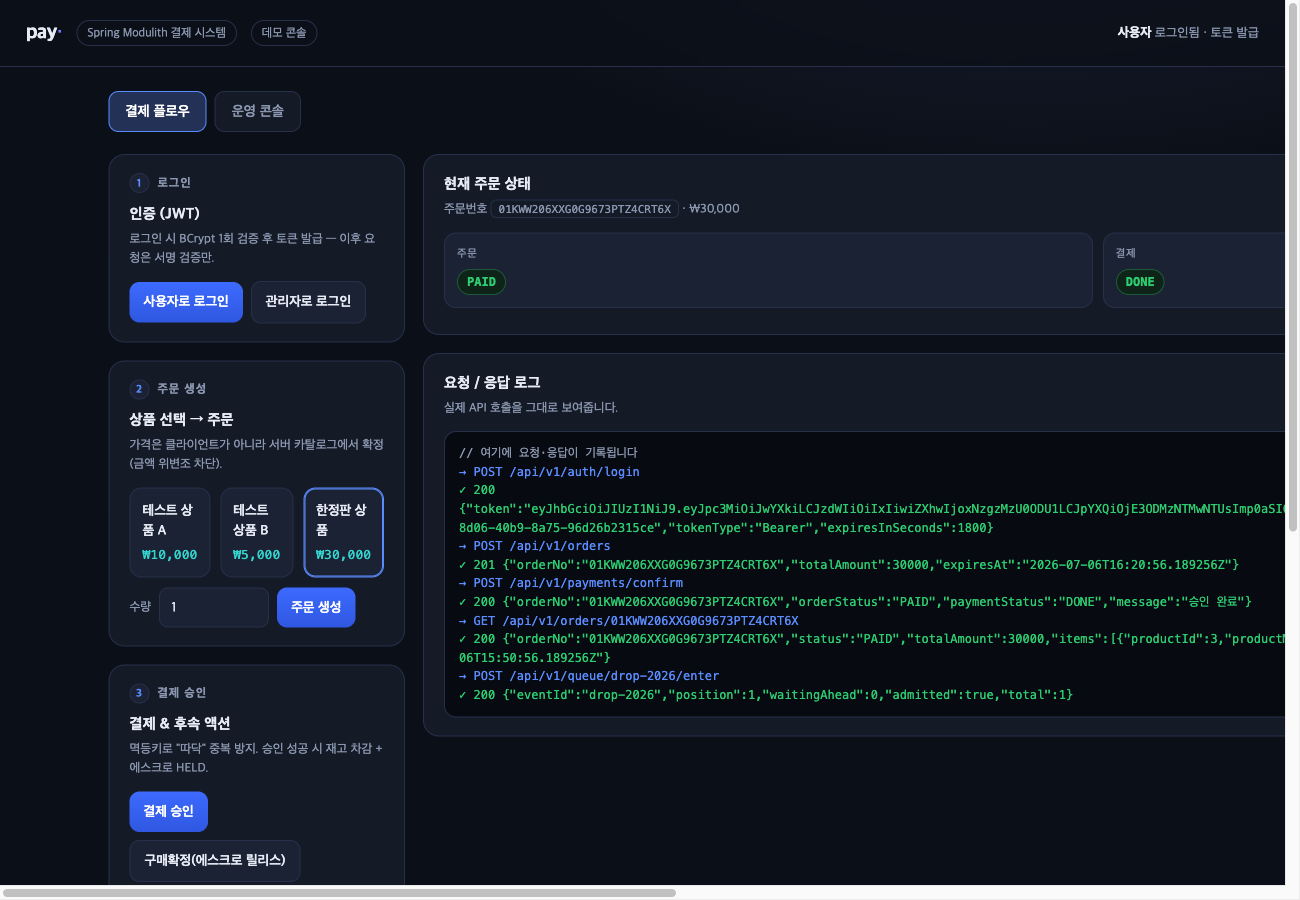
pay — Spring Modulith 결제 시스템
결제 승인·취소부터 원장·정산·대사·구독·분쟁까지 처리하고, FDS와 배치·AI 기반 운영 자동화로 이상 거래와 운영 예외를 탐지·분류하는 결제 시스템입니다.

위키엔진
1,215만 건의 위키 문서를 Lucene으로 색인·검색하고, 캐시와 읽기·쓰기 분리로 트래픽을 처리하는 통합 검색 플랫폼입니다.

db-hobby — C로 만든 미니 RDBMS
psql로 접속해 SQL을 실행할 수 있고, 저장·인덱스·트랜잭션·복구·복제를 직접 구현한 C 기반 학습용 RDBMS입니다.

최신 스토리
AI 코딩, 저는 이렇게 개발하고 있습니다
설계는 메인 세션이, 구현은 싼 코더가, 검토는 다른 모델이 맡습니다. 이 구조를 직접 자동화하면서 가장 오래 붙잡은 문제는 AI가 정말 일을 끝냈는지 믿는 방법이었습니다. 완료 표식이 두 번 거짓으로 통과한 뒤 판정 방식을 다시 세웠습니다.
AI가 짜준 코드를 어디까지 기계한테 검증시킬 수 있을까?
처음에는 검증 충분성을 기계가 결정적으로 판정하게 만들려 했다. 그런데 사람이 하던 그 판단은 원래 확률적이었다. 그래서 갈라야 할 것은 무엇을 고정하고 무엇을 맡길 것인가였다. 고정할 자리에는 경계와 검사를 두고, 맡길 자리에는 판단할 재료를 준다. 다만 자기를 심판하는 자리 하나는 기계가 붙잡아야 한다.

데이터베이스 인덱스 ⑥: 운영과 한계
인덱스 시리즈 마무리. 운영 환경의 인덱스 작업은 DDL이 DB를 멈출 수 있다는 사실에서 출발합니다. CREATE INDEX CONCURRENTLY의 4단계 phase와 제약, 장기 트랜잭션이 클러스터 전반의 VACUUM/IOS에 미치는 영향, 인덱스 bloat과 REINDEX, 수십억 행을 위한 파티셔닝/샤딩, Bloom Filter, 그리고 6가지 안티패턴까지 1차 자료 기준으로 정리합니다.

데이터베이스 인덱스 ⑤: 클러스터형 인덱스와 DBMS별 차이
PostgreSQL의 heap-organized 모델과 MySQL InnoDB의 clustered index 모델은 근본적으로 다른 세계관입니다. 같은 SQL이라도 저장 구조에 따라 plan과 비용이 전혀 달라지고, secondary index 동작·PK 선택 전략·DBMS 이전 시 함정이 모두 달라집니다. PG/MySQL/SQL Server/Oracle 비교를 1차 자료 기준으로 정리.

데이터베이스 인덱스 ④: 복합 인덱스와 좌측 컬럼 규칙
복합 인덱스는 컬럼들의 정렬 순서를 그대로 B-tree에 반영한 자료구조입니다. 같은 세 컬럼이라도 순서를 바꾸면 전혀 다른 인덱스가 되고, leftmost prefix rule이 활용 방식을 결정합니다. ESR Rule(Equality·Sort·Range) 가이드라인, PG18 skip scan, AND vs OR, INCLUDE와의 차이까지 1차 자료 기준으로 정리.

데이터베이스 인덱스 ③: Covering Index와 Index-Only Scan
plan에 Index Only Scan이 잡혔다고 진짜 IOS는 아닙니다. PostgreSQL의 IOS는 covering(쿼리 컬럼이 인덱스에)과 visibility(VM all-visible) 두 단계 조건을 모두 만족해야 Heap Fetches가 0이 됩니다. INCLUDE 절은 covering을, VACUUM은 visibility를 충족시키는 도구입니다. INCLUDE의 leaf-only 저장 메커니즘과 인덱스 타입별 IOS 지원, 그리고 PG12 이전 insert-only Mandrill 함정까지 다룹니다.

데이터베이스 인덱스 ②: 스캔의 종류와 옵티마이저의 선택
인덱스가 있다고 모든 쿼리가 같은 방식으로 그 인덱스를 쓰는 것은 아닙니다. PostgreSQL의 Sequential / Index / Index-Only / Bitmap Scan 4가지 전략과, 옵티마이저가 통계 기반 셀렉티비티 추정으로 그 중 하나를 고르는 메커니즘을 1차 자료 기준으로 정리합니다. correlation, work_mem, BitmapAnd, Index Cond vs Filter까지.

데이터베이스 인덱스 ①: 인덱스 기초와 EXPLAIN 읽기
인덱스는 검색용 보조 자료구조이고, 그 인덱스를 쓸지 말지를 결정하는 것은 옵티마이저입니다. 옵티마이저의 결정을 검증하는 도구가 EXPLAIN이고, 실측까지 더하는 것이 EXPLAIN ANALYZE입니다. cost가 임의 단위라는 점, 추정과 실측의 격차가 진단의 핵심 신호라는 점, 인덱스가 있어도 안 쓰이는 4가지 패턴까지 1차 자료 기준으로 정리합니다.