DBTower 프로젝트 소개: 다섯 종류의 DB를 한곳에서 관제하고 안전하게 바꾸는 운영 플랫폼
목차
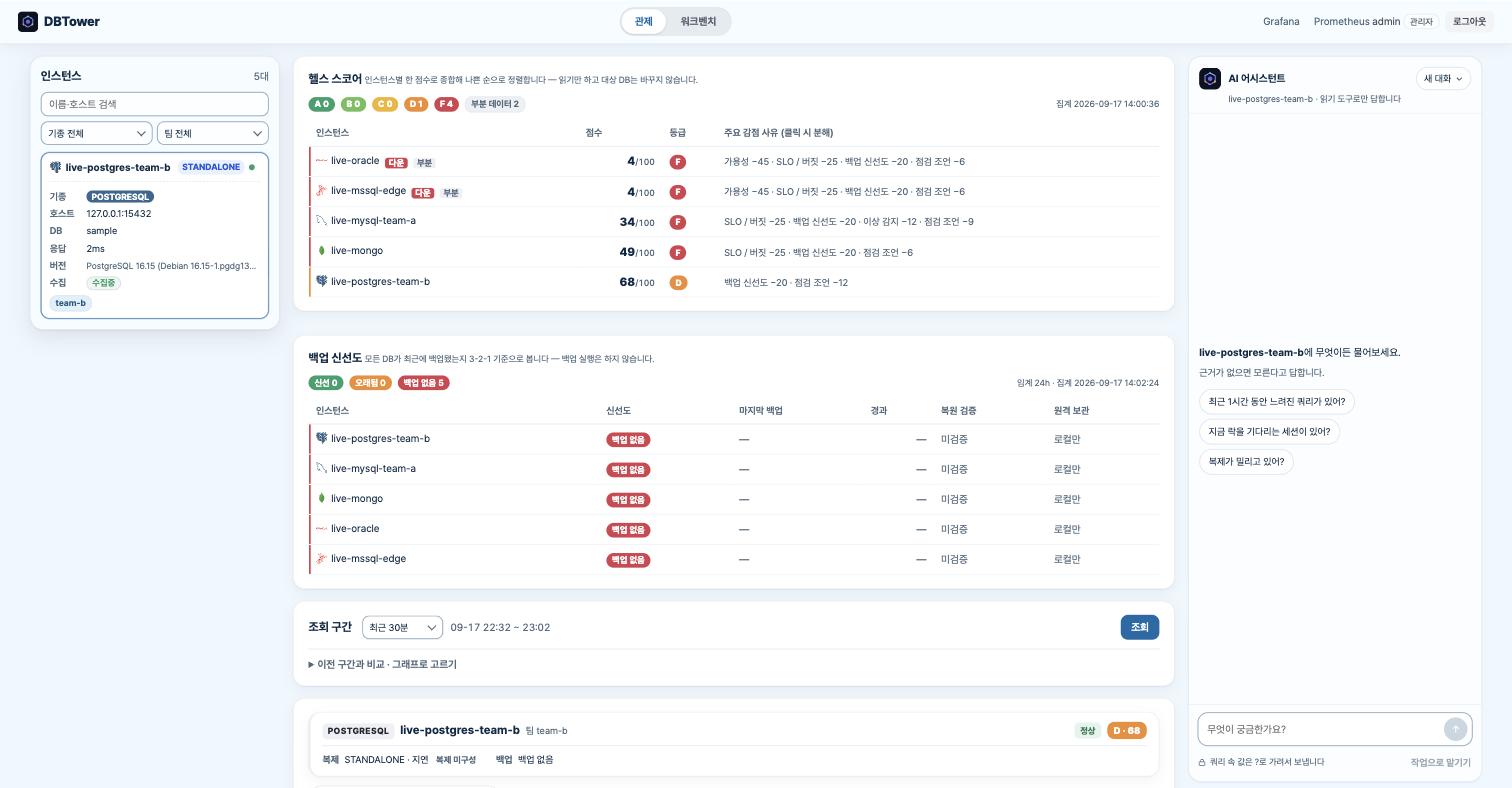
DBTower는 MySQL, PostgreSQL, SQL Server, Oracle, MongoDB를 한곳에서 관제하고 안전하게 변경하는 셀프호스트 DB 운영 플랫폼입니다. 회사 서버에 직접 설치해서 쓰는 형태입니다. 관제에서 진단, 변경 요청, 승인, 실행, 전후 비교까지 한 흐름으로 이어집니다.
한눈에 보기
| 항목 | 내용 |
|---|---|
| 한 줄 소개 | 이기종 DB 다섯 종류를 한 화면에서 관제·진단하고, 승인된 변경만 실행하는 운영 플랫폼 |
| 기간 | 2026.03 ~ 진행 중 (개인 프로젝트) |
| 현재 버전 | v1.4.0 (2026-09-17 공개) |
| 기술 | Java 21, Spring Boot 4, Spring Modulith, PostgreSQL(메타 DB), Docker, MCP |
| 설치 | Docker Compose 한 번으로 앱과 메타 DB 실행 |
| 코드 | github.com/dj258255/dbtower (Apache-2.0) |
| 작업 관리 | 이슈 44건, PR 62건(2026-09-18 기준). 이슈로 적고 PR로 올리고 VERIFICATION.md에 남기고 CHANGELOG로 발행 |
왜 만들었나
회사에서 DB가 한 종류만 쓰이는 경우는 드뭅니다. 기종이 늘면 지표를 보는 도구도, 실행계획을 읽는 방법도, 백업 명령도 기종마다 달라집니다. 이런 환경에서 반복해서 보이는 문제가 세 가지 있었습니다.
- DBA에게 같은 질문이 반복됩니다. 쿼리가 느려지면 개발자는 기종마다 흩어진 지표를 오가다 결국 DBA에게 묻습니다. DBA는 비슷한 질문에 계속 답합니다.
- 변경의 증거가 남지 않습니다. 변경을 DB 클라이언트에서 따로 실행하면 승인된 SQL과 실제로 실행된 SQL이 같다는 기록도, 되돌릴 사본도, 변경 전후 비교도 남지 않습니다.
- 관리할 DB가 늘수록 사람 손도 그만큼 늘어납니다.
DBTower는 기종 차이를 플랫폼 안쪽으로 숨겨서, 쓰는 사람은 어떤 DB든 같은 화면과 같은 절차로 다루게 하려고 만들었습니다.
누구를 위한 도구인가
한 플랫폼을 여러 사람이 각자의 역할로 씁니다. 역할은 다섯 가지입니다. 화면은 로그인한 사람이 할 수 있는 일에 맞춰 버튼을 보여 줍니다. 최종 권한 검사는 서버가 합니다.
| 역할 | 주 사용자 | 이 사람이 하는 일 |
|---|---|---|
관제 (VIEWER) | 온콜 담당자, 팀장 | 지금 어떤 DB가 나쁜지 보고, 평소와 문제 구간을 비교하고, 리포트를 확인합니다 |
요청자 (REQUESTER) | 개발자, 데이터 요청자 | 읽기 전용 워크벤치에서 조회하고, 필요한 변경을 요청합니다 |
승인자 (APPROVER) | DBA 리드 | 변경 요청을 검토해 승인하거나 반려하고, 실행 전 드라이런을 봅니다 |
운영자 (OPERATOR) | DBA 운영자 | 승인된 요청만 실행하거나 되돌리고, 백업과 세션 종료를 맡습니다 |
관리자 (ADMIN) | 플랫폼 관리자 | 관리 대상 DB, 계정, 보안 설정, 감사 기록을 관리합니다 |
승인자와 운영자는 서로의 일을 할 수 없게 나눴습니다. 한 사람이 자기가 승인한 변경을 직접 실행하는 일을 구조적으로 막기 위해서입니다.
주요 기능
1. 관제: 지금 어디가 나쁜지 한 화면에서
- 등록한 DB마다 쿼리 통계, 활동 그래프, 대기 이벤트(Wait Event), 세션과 블로킹, 복제와 백업 상태를 모아 보여 줍니다.
- 통합 헬스 스코어가 여러 신호를 점수 하나로 합쳐 나쁜 순서로 정렬합니다. 아침에 이 화면만 열면 먼저 볼 DB가 위에 있습니다.
- 시점 비교로 평소 구간과 문제 구간을 나란히 놓고, 어떤 쿼리가 얼마나 늘었는지, 새로 나타난 쿼리가 무엇인지 봅니다.
- 쿼리 성능 회귀, 이상 징후, 실행계획 변경, 데드락을 자동으로 감지하고, 경보는 Discord·Slack 웹훅으로 보냅니다.
2. 진단: 느린 쿼리의 원인까지
- 실행계획을 규칙으로 읽어 풀스캔 같은 비효율을 먼저 짚습니다.
- 실제 실행계획에서 옵티마이저가 추정한 행 수와 실제 행 수의 차이를 비교해, 따옴표 하나 때문에 인덱스를 못 타는 암시적 형변환 같은 원인을 찾습니다.
- PostgreSQL에서는 HypoPG 가상 인덱스로 인덱스를 실제로 만들지 않고 효과를 미리 봅니다.
3. AI 운영 작업: 사실은 플랫폼이, 소견은 모델이
Slack 한 문장, 웹 콘솔, 경보, DB팀 문의에서 진단 작업을 시작할 수 있습니다. 수치와 기록 같은 사실은 DBTower가 직접 모읍니다. AI 모델은 그 사실을 바탕으로 1차 소견만 냅니다. 소견에 나온 수치는 모은 사실과 다시 대조해서 맞지 않으면 “검증되지 않음”으로 표시합니다.
AI에게 보내는 쿼리 속 값은 ?로 가립니다. AI와 MCP 채널에는 변경을 실행하는 도구를 아예 열어 두지 않았습니다.
4. 변경 관리: 승인된 변경만, 되돌릴 사본과 함께
변경은 아래 순서를 한 번도 건너뛰지 않습니다.
관제 -> 문제 구간 비교 -> 실행계획·원인 분석 -> 변경 요청 -> 승인 -> 실행 -> 전후 비교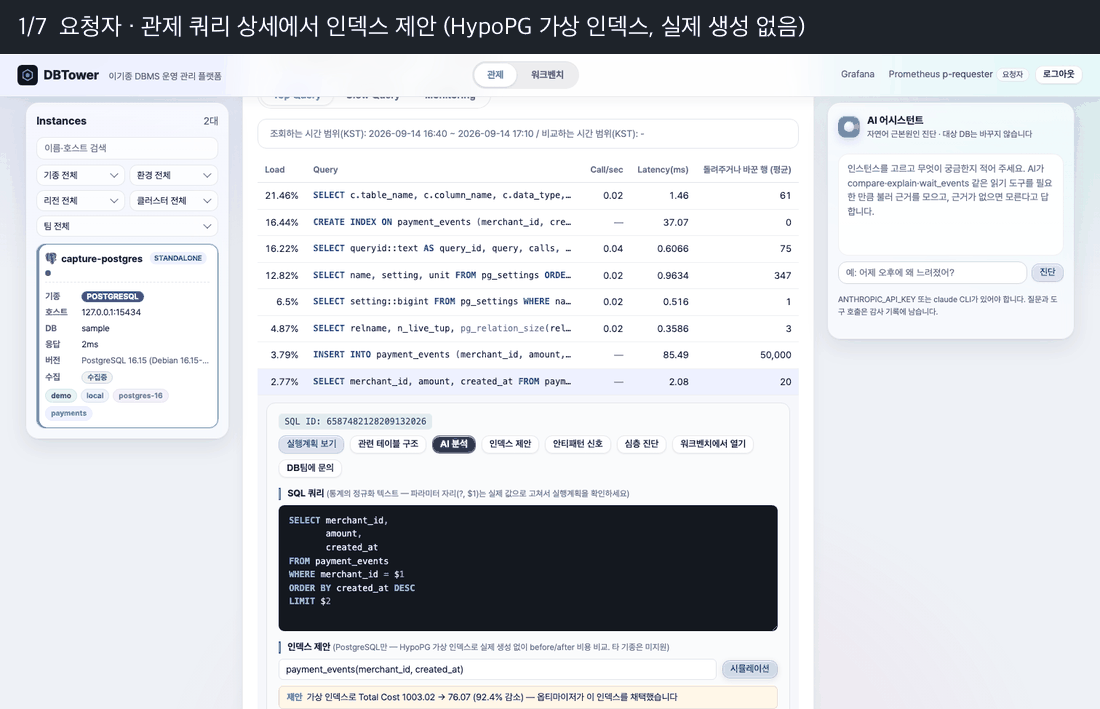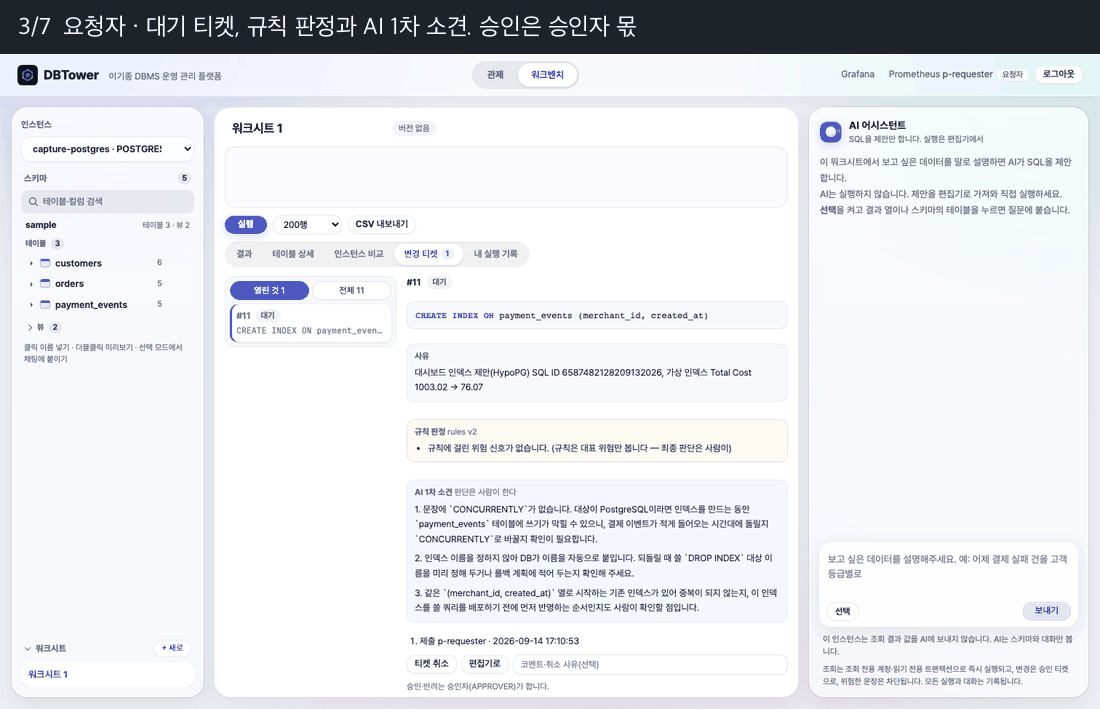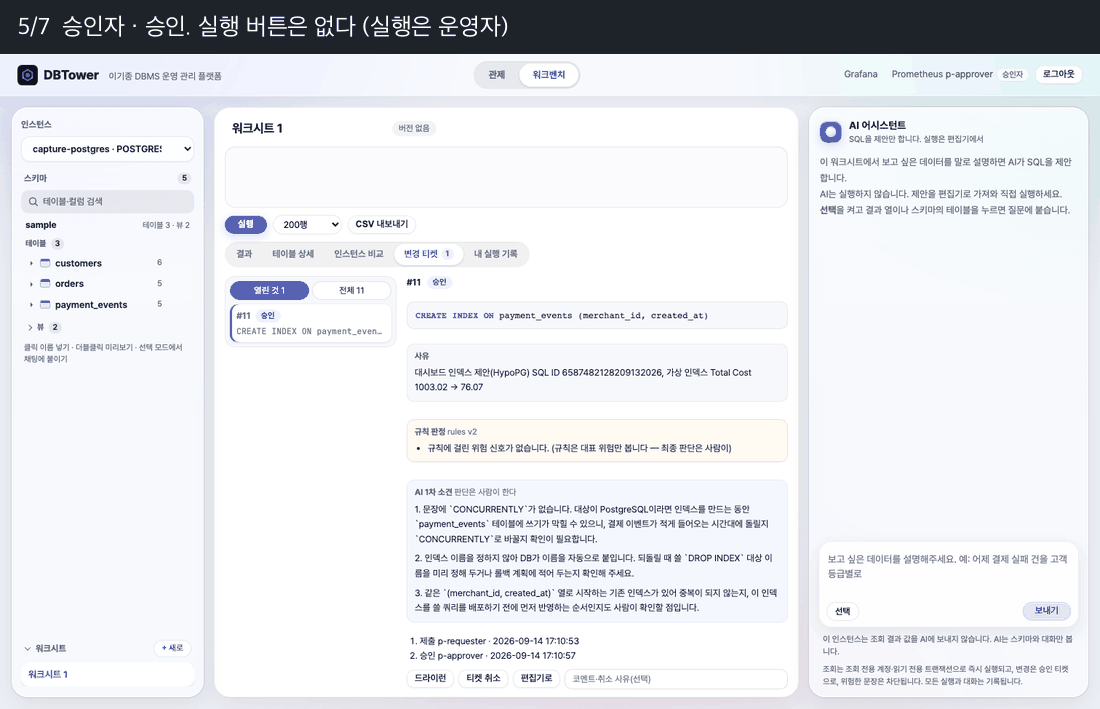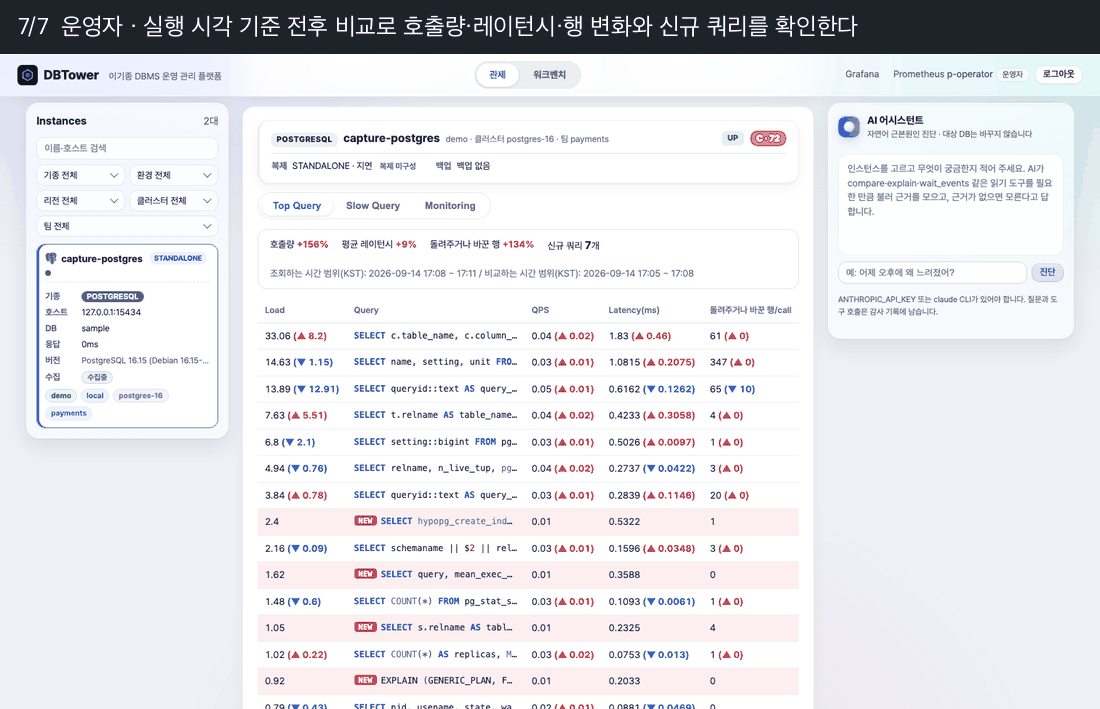
- 실행 직전에 바뀔 행을 복사해 둡니다. 복사한 행 수와 DB가 알려 준 실제 영향 행 수가 다르면 커밋하지 않습니다.
- 되돌리기는 복사해 둔 사본과 지금 행이 같을 때만 허용합니다. 그 사이 다른 누군가가 행을 바꿨다면 덮어쓰지 않습니다.
- 같은 요청을 두 사람이 동시에 실행하면 한 명만 실행권을 얻습니다.
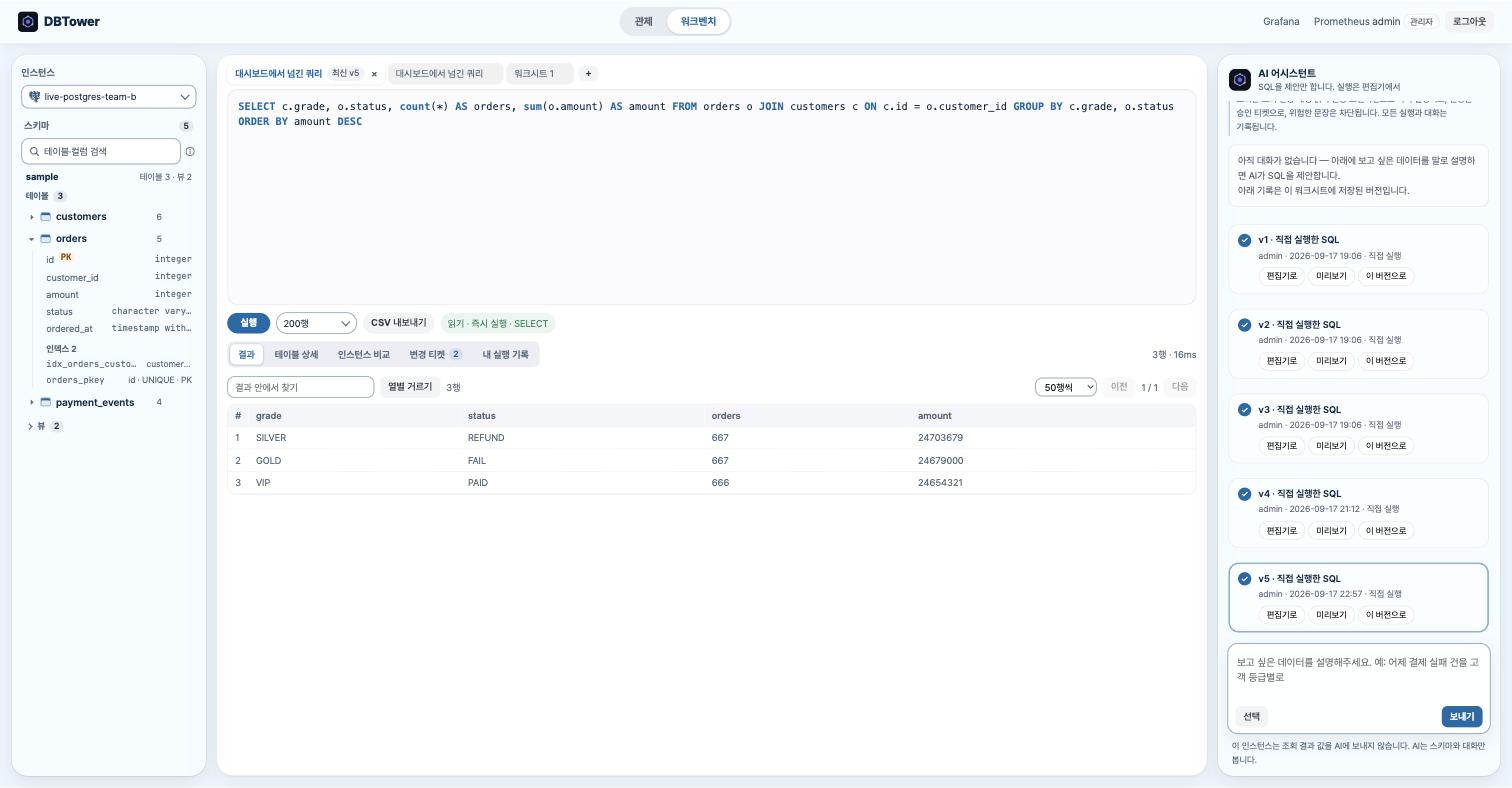
조회는 워크벤치에서 합니다. 스키마 트리와 워크시트 탭이 있는 SQL 편집 화면입니다. 조회 전용 계정과 읽기 전용 트랜잭션으로 돌아가며 민감한 값은 가려서 보여 줍니다.
5. 운영: 백업과 약속한 품질
- 백업이 얼마나 최근에 성공했는지(백업 신선도)를 보고, 백업을 실제로 복원해 검증합니다.
- SLO와 에러 버짓, 운영 규칙 자동 점검(Advisors), 쓰이지 않는 인덱스 같은 비용 신호를 제공합니다.
- Kubernetes(CloudNativePG)와 Ansible로 만든 DB를 플랫폼에 등록하는 연동이 있습니다. Terraform 모듈은 문법 검증까지만 했고 실제 클라우드에 적용해 보지는 않았습니다.
지원하는 DB
기종마다 통계를 읽는 곳과 실행계획 형식, 백업 방식이 다릅니다. 이 차이는 DbmsOperator라는 인터페이스 뒤에 숨겨 두어, 관제와 진단과 변경 기능은 기종을 가리지 않고 같은 코드를 씁니다.
| DB | 쿼리 통계 | 실행계획 | 백업 |
|---|---|---|---|
| MySQL 8.0 이상 | performance_schema | JSON EXPLAIN | mysqldump 등 외부 도구 |
| PostgreSQL 13 이상 | pg_stat_statements | TEXT/JSON EXPLAIN | pg_dump 등 외부 도구 |
| SQL Server 2019 이상 | DMV, Query Store | 플랜 XML | BACKUP DATABASE |
| Oracle 19c / Free | V$SQL | DBMS_XPLAN | DBMS_DATAPUMP, RMAN |
| MongoDB 6.0 이상 | profiler, server status | explain JSON | mongodump |
안전을 위해 정한 원칙
운영 DB를 다루는 도구라서 기능을 만들기 전에 안전 규칙부터 정했습니다.
- 모니터링 조회는 읽기 전용 계정과 쿼리 타임아웃을 씁니다.
- 대상 DB 하나가 응답하지 않아도 플랫폼 전체가 멈추지 않도록 커넥션과 수집 작업을 DB마다 따로 둡니다.
- 요청, 승인, 실행의 모든 단계를 감사 기록에 남깁니다.
- 관리 대상 DB의 비밀번호는 AES-256-GCM으로 암호화해 저장하고, API 응답이나 외부 명령 인자에 노출하지 않습니다.
구조
플랫폼은 Spring Modulith로 나눈 모듈 17개로 이루어져 있습니다. 모듈끼리는 공개된 서비스와 DTO만 씁니다. 구현과 엔티티는 각 모듈의 internal 패키지에 숨깁니다. 모듈 사이에 순환 의존이 생기면 테스트가 실패하므로 모듈 경계를 빌드가 검사합니다.

기종 차이를 맡는 핵심은 operator 모듈입니다. 새 DB를 지원할 때 본체는 Operator 구현체 하나입니다. 나머지는 등록 절차로 다룹니다.
일정과 작업 방식
전체 개발 기간은 2026년 3월부터 지금까지이며 커밋은 483개입니다. 월별로 보면 3월 9개, 4월 9개, 5월 11개, 6월 13개로 천천히 쌓이다가 7월에 216개로 몰렸고 8월 35개를 거쳐 9월에 190개가 들어갔습니다.
태그와 CHANGELOG를 기준으로 단계를 나누면 다음과 같습니다.
| 기간 | 단계 | 산출물 |
|---|---|---|
| 2026-03 ~ 06월 | MVP 세 가지(이기종 등록·헬스체크, 시점 비교, EXPLAIN 규칙 분석)와 성능·확장 작업 | 태그 이전, 커밋 42개 |
| 2026-07-06 ~ 07-07 | 5기종 지원과 인증·암호화·감사·백업 복원 검증으로 첫 공개, 이어서 심화 네 아크로 다섯 기종을 고르게 다듬고 하드닝 | v1.0.0, v1.0.1, v1.1.0 |
| 2026-07-19 | 운영 병목 다섯 곳(설정 드리프트, 리뷰 게이트, 인덱스 사용 통계, 인시던트, 월간 리포트)을 끊고 콘솔을 사이드바 구조로 개편 | v1.2.0 |
| 2026-07-19 ~ 09-14 | 거버넌스 SQL 워크벤치(조회부터 승인 실행까지), 역할 5종 분리, 실시간 세션 관제, 세션 샘플링 | v1.3.0, v1.3.1 |
| 2026-09-15 ~ 09-17 | Slack 등 네 입구를 하나의 AI 운영 작업 모델로 묶고 콘솔 화면을 사람이 쓰는 순서로 다시 짬 | v1.4.0 |
| 2026-09-17 ~ 진행 중 | 화면 재설계 2차, 대량 일괄 변경 준비 | v1.5.0(마일스톤, 진행 중) |
이슈와 PR로 작업을 나누는 방식은 v1.3.0 전후부터 자리잡았습니다. 문제는 이슈로 먼저 적습니다. 고친 내용은 PR로 올립니다. 실제로 돌려 본 명령과 출력은 docs/VERIFICATION.md에 절 번호를 붙여 남깁니다. 배포되는 변경은 CHANGELOG에 적습니다. 지금까지 이슈 44건(열림 15건, 닫힘 29건), PR 62건이 쌓였습니다.
예상 시간은 2026-09-17부터 기록을 시작했습니다. 그 전까지는 로드맵과 명세 문서에 우선순위와 완료 조건만 있고 예상 시간은 없었습니다. 아래는 그날 이후 실제로 적어 둔 이슈 몇 건의 예상과 실제입니다.
| 이슈 → PR | 작업 | 예상 | 예상 마감 | 실제 마감 | 어긋난 이유 |
|---|---|---|---|---|---|
| #66 → PR #67 | UX 1차 검증 기록과 CHANGELOG 정리 | 2시간 | 09-17 23:20 | 09-17 21:54 | 앞선 작업에서 이미 확인한 수치와 화면이라 새로 잴 것이 없었습니다 |
| #61 → PR #68 | 글자 크기 네 단계 기준 적용, 시간대 선택 접기 | 4시간 | 09-18 07:20 | 09-17 23:04 | 값 대응표 하나로 한 번에 바꿨습니다 |
| #69 → PR #74 | 문서 대표 화면 10장 재촬영 | 2시간 | 09-18 00:40 | 09-17 23:15 | 촬영 중 발견한 스냅샷 저장 실패(#70)를 먼저 고치는 작업이 끼었습니다 |
| #70 → PR #71 | 스냅샷 저장 실패 수정 | 1시간 | 09-17 23:43 | 09-17 23:08 | 수정 전 재현에서 수집 재시도 간격만큼 약 10분을 기다렸습니다 |
직접 재 본 결과
성능 수치는 모두 고치기 전과 후를 같은 조건에서 직접 쟀습니다. 명령과 출력 원문은 저장소의 VERIFICATION.md에 남겼습니다.
| 확인한 것 | 전 | 후 |
|---|---|---|
| 시점 비교 조회, 50만 행 (플랫폼이 자기 메타 DB를 진단해 복합 인덱스 추가) | 21.269 ms | 0.062 ms |
| 인덱스 변경 티켓 실행 전후, 같은 부하의 평균 지연 (pgbench, 행 20건 조회) | 46.378 ms | 0.521 ms |
| 응답 없는 대상 DB 하나가 헬스 체크 폴러 전체를 막던 시간 | 25초 초과 | 약 2초 |
| 세션 화면을 10명이 30초 동안 볼 때 대상 DB가 받은 조회 수 | 150회 | 14회 |
Slack에 한 문장으로 진단을 요청하면 확인 응답은 65.6 ms에 옵니다. 검증을 거친 소견은 31.7초 뒤에 도착했습니다(로컬 서명 요청 기준).
아직 못 한 것
- 실제 Slack 워크스페이스에는 붙여 보지 않았습니다. 서명 검증, 중복 요청 처리, 스레드 응답은 로컬에서 서명한 요청으로 확인했습니다.
- 경보에서 AI 작업이 자동으로 생기는 기능은 기본값이 꺼져 있습니다.
- 참고 자료 검색 품질은 상위 3개 결과 중 관련 있는 절이 27개 중 11개 수준입니다.
- 실제 회사 환경에서 여러 사람이 오래 써 본 적은 없습니다. 지금까지의 검증은 로컬 Docker와 CI 위에서 한 것입니다.
직접 실행해 보기
Docker와 Docker Compose만 있으면 됩니다.
git clone https://github.com/dj258255/dbtower.gitcd dbtowercp .env.example .env.env에서 최소 두 값을 정합니다.
DBTOWER_DB_PASSWORD=change-me-strong-passwordDBTOWER_ENCRYPTION_KEY=<openssl rand -base64 32 결과>DBTOWER_TAG=1.4.0docker compose -f docker-compose.app.yml up -d웹 콘솔은 http://localhost:8080에서 열립니다. 관리자 비밀번호를 따로 정하지 않았다면 docker compose -f docker-compose.app.yml logs dbtower로 최초 비밀번호를 확인할 수 있습니다. 관리할 DB는 로그인한 뒤 웹 콘솔에서 등록합니다.
더 보기
- 코드와 설치 문서: GitHub 저장소
- 설계 결정: DESIGN.md
- 역할별로 직접 눌러 보는 순서: MANUAL-TEST.md
- 현재 화면 모음: SCREENSHOTS.md
- 관제 데이터를 오래 보관해 분석하는 파이프라인: dbtower-lakehouse

댓글
댓글 수정/삭제는 GitHub Discussions에서 가능합니다.