위키엔진 프로젝트 소개: 1천만 건 위키 문서를 검색하는 통합 검색 플랫폼
목차
위키엔진은 나무위키와 한국어·영어 위키백과, 뉴스, 웹텍스트 등 공개 데이터셋 1,215만 건을 커뮤니티 게시판 형태로 변환해 적재하고 Lucene으로 색인해서 검색하는 개인 프로젝트입니다. 검색 한 번이 5초 넘게 걸리던 MySQL LIKE 검색에서 시작해 병목이 나타날 때마다 다음 구조로 옮겨가는 과정을 그대로 기록했습니다.
한눈에 보기
| 항목 | 내용 |
|---|---|
| 한 줄 소개 | 1,215만 건의 위키 문서를 Lucene으로 색인하고 검색하며 캐시와 읽기·쓰기 분리로 트래픽을 처리하는 검색 플랫폼 |
| 기간 | 2026.02 ~ 2026.05 (개인 프로젝트), 문서화 정리는 2026.05.19 |
| 데이터 규모 | 6개 공개 데이터셋 합계 12,156,589건, 30개 카테고리, 고유 태그 약 216만 개 |
| 기술 | Spring Boot, Java, Lucene, Nori, MySQL, Redis, Kafka, Debezium, Next.js |
| 서비스 상태 | 2026년 5월 라이브를 종료했습니다. 지금은 코드와 문서로만 남아 있습니다 |
| 코드 | github.com/dj258255/wikiEngine |
왜 만들었나
시작은 검색 기능 하나였습니다. 나무위키와 위키백과 덤프를 그대로 가져오면 카테고리 문서와 틀 문서가 뒤섞여 있어서 이 데이터를 실제 커뮤니티 게시판처럼 바꿔서 적재하는 작업부터 했습니다. 위키의 [[분류:XXX]]는 태그와 카테고리로 바꿨습니다. 뉴스와 웹 콘텐츠에는 소스별 고정 카테고리를 붙였습니다. 작성자와 작성일은 10만 명의 더미 유저와 2020~2025년 범위로 흩어서 실제 서비스에 가까운 읽기 패턴이 나오게 만들었습니다.
그다음 목표는 “검색 기능을 만들었다”에서 멈추지 않는 것이었습니다. 데이터가 1,200만 건을 넘는 순간 MySQL LIKE 검색은 5초 넘게 타임아웃이 나기 시작했습니다. 이 시점부터는 가장 느린 상태에서 출발해 병목이 드러날 때마다 다음 기술로 옮겨가는 과정 전체를 기록하는 것이 프로젝트의 목표가 됐습니다. 검색 엔진 전환, 캐시, 분산 아키텍처, 검색 품질 고도화까지 각 단계에서 무엇을 포기하고 무엇을 얻었는지를 수치로 남겼습니다.
누구를 위한 서비스인가
| 쓰는 사람 | 이 사람이 얻는 것 |
|---|---|
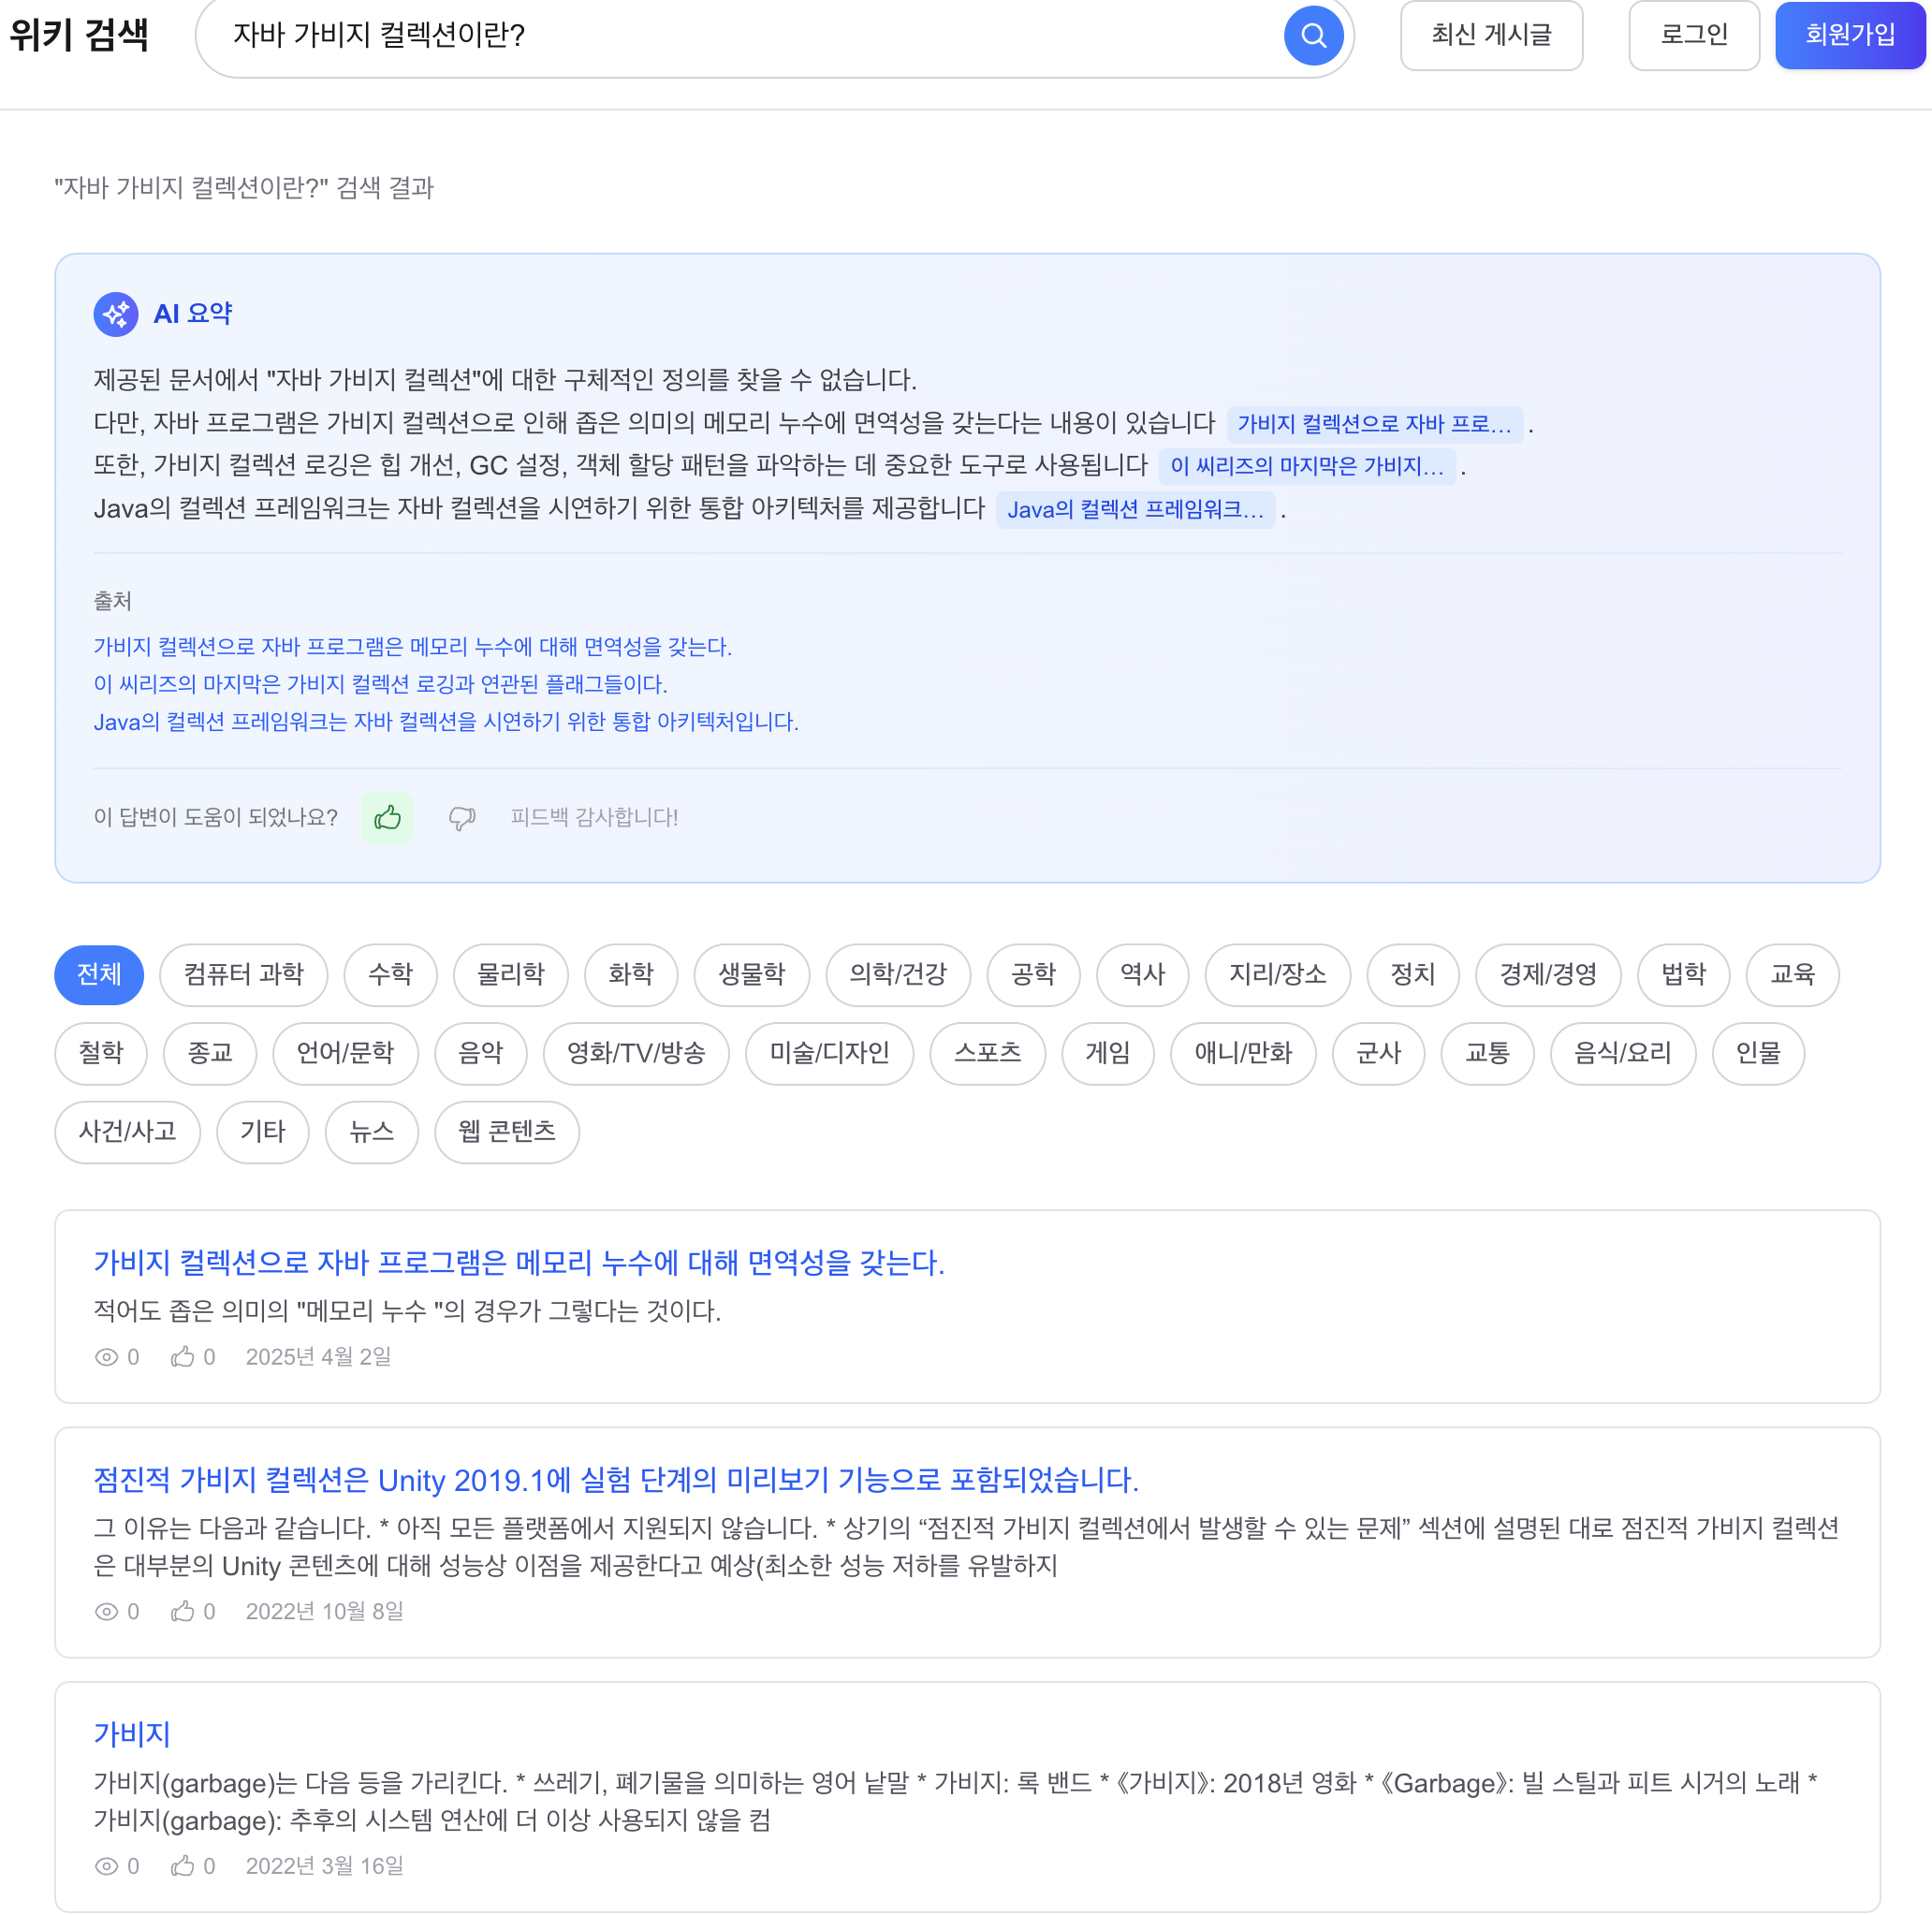
| 검색하는 방문자 | 형태소 분석 기반 검색, 오타 교정, 카테고리 필터, AI 요약으로 원하는 문서를 빠르게 찾습니다 |
| 글을 쓰는 사용자 | Tiptap 에디터로 글을 쓰고 카테고리를 고르면 자동으로 분류와 색인이 이어집니다 |
| 이 기록을 읽는 엔지니어 | 각 전환 단계에서 무엇을 측정하고 무엇을 근거로 결정했는지를 ADR과 블로그로 따라갈 수 있습니다 |
주요 기능
1. 검색
Lucene BM25로 제목과 본문에 서로 다른 가중치를 줍니다. Nori 형태소 분석기로 한국어 조사와 어미를 분리합니다. 동의어 확장으로 AI와 인공지능을 같은 의미로 묶습니다. DirectSpellChecker로 오타에도 “혹시 OO을 찾으셨나요” 제안을 돌려줍니다. 검색어 주변 맥락을 보여주는 snippet은 UnifiedHighlighter로 만듭니다.
2. 자동완성
접두사 입력마다 후보를 다시 탐색하지 않습니다. 검색 로그를 배치로 집계해 접두사별 상위 추천을 미리 만들어 둡니다. 조회는 Redis flat KV에서 O(1)로 읽습니다. 집계는 별도 경로에서 처리해서 빠른 응답과 안정적인 누적이 서로를 방해하지 않게 나눴습니다. 한글 자모 분해도 지원해서 삼ㅅ을 입력하면 삼성전자가 제안됩니다.
3. 필터와 랭킹
검색 결과는 28개 주제 카테고리로 Facet 집계됩니다. 기본 랭킹은 BM25에 인기도와 최신성을 반영합니다. 그 위에 XGBoost LambdaMART로 학습한 재랭킹 모델을 얹어 제목 길이나 태그 중복 같은 피처 간 상호작용까지 반영하도록 만들었습니다.
4. AI 검색 요약
검색으로 찾은 상위 문서를 그대로 컨텍스트로 넘겨 Gemini가 답을 생성하는 RAG 파이프라인입니다. 답변은 SSE로 스트리밍되어 검색 결과를 기다리는 흐름을 막지 않습니다. 답변 안에는 [문서 N] 형태의 인라인 인용을 강제해서 어느 문서를 근거로 요약했는지 확인할 수 있습니다.
5. 콘텐츠 필터링
게시글 작성 시 Aho-Corasick 알고리즘으로 금칙어 16,090개를 한 번의 텍스트 순회 안에서 동시에 검사합니다. 걸린 게시글은 삭제하지 않고 blinded 상태로 검색과 자동완성에서만 제외합니다. 오탐이 나와도 다시 색인하지 않고 즉시 복원할 수 있습니다.
구조

Oracle Cloud Free Tier 서버 4대로 구성했습니다. 서버 1은 Nginx와 Spring Boot Primary, MySQL Primary, Lucene 인덱스(42GB)를 담당합니다. 서버 2는 App Replica와 MySQL Replica, Kafka, Debezium, Redis 샤드 2대를 담당합니다. 나머지 서버 2대는 Prometheus와 Grafana, Loki로 모니터링만 맡습니다.
읽기 요청은 Nginx가 두 App 인스턴스로 나눠 보내고 쓰기 요청은 Primary로 고정합니다. 게시글이 저장되면 MySQL binlog를 Debezium이 읽어 Kafka로 흘려보냅니다. Lucene 색인과 캐시 무효화는 이 이벤트를 각자 독립적으로 소비합니다. Lucene은 Primary가 색인을 쓰고 Replica가 그 파일을 따라가는 구조입니다.
고민한 선택
기능 하나하나에 정답이 있는 결정은 굳이 트레이드오프로 포장하지 않았습니다. 실제로 무언가를 포기해야 했던 선택만 남겼습니다.
Lucene 직접 임베드 대 Elasticsearch. 서버는 2 vCPU, 12GB RAM 한 대였고 여기에 Spring Boot와 MySQL이 이미 같이 돌고 있었습니다. Elasticsearch는 단일 노드도 8GB 힙을 권장해서 이 한 대에 올리면 나머지가 버틸 수 없었습니다. Lucene을 앱과 같은 JVM에 직접 넣으면 이 문제는 풀립니다. 그 대가로 분산 검색과 복제는 rsync와 CDC로 직접 구현해야 했고 Kibana 같은 관리 도구도 포기해야 했습니다. 데이터가 5천만 건을 넘거나 리전 간 복제가 필요해지면 이 결정을 다시 봐야 한다고 ADR에 남겨 뒀습니다.
읽기 확장 대 강한 일관성. App을 2대로 늘리기 전에 먼저 물은 것은 “App을 늘린 뒤에도 지금 DB 구조가 버티는가”였습니다. 답은 읽기와 쓰기를 나누는 것이었습니다. 그러려면 강한 일관성을 최종 일관성으로 바꿔야 했습니다. 게시글을 수정한 직후 아주 짧은 시간 동안 이전 데이터가 보일 수 있다는 뜻입니다. 커뮤니티 게시판이라는 서비스 특성상 이 정도 지연은 감당할 수 있다고 판단했고 실제 복제 지연은 0~1초 수준으로 유지됐습니다.
Kafka CDC 대 애플리케이션 비동기 이벤트. 처음에는 게시글을 저장한 뒤 검색 인덱스와 캐시를 같은 요청 안에서 직접 갱신했습니다. 이 방식은 한쪽만 성공하는 partial failure가 나면 정합성이 흔들렸습니다. 애플리케이션 내부 비동기 이벤트로 바꾸자 응답은 가벼워졌습니다. 그러나 애플리케이션을 거치지 않은 DB 변경은 여전히 놓쳤고 실패를 다시 따라가 복구할 기준도 없었습니다. Kafka와 Debezium CDC를 더한 이유는 DB에 실제로 기록된 변경을 기준으로 다시 재생할 수 있다는 점이었습니다. 그만큼 운영해야 하는 인프라도 늘었습니다.
검색 품질 대 운영 비용, LTR 재랭킹. LambdaMART 재랭킹은 5-Fold 교차 검증에서 NDCG@10을 0.6910에서 0.7387로 올렸습니다. 그런데 2코어 ARM 서버에서 100 VU 부하로 LTR을 켠 채 측정하면 검색 평균 응답이 29.18ms에서 8,826ms로 나빠졌고 LTR과 무관한 자동완성 API까지 함께 느려졌습니다. 품질 지표가 좋아졌다는 이유만으로 운영에 바로 넣지 않았습니다. 지금 인프라가 그 비용을 감당하지 못한다는 사실을 그대로 받아들여 운영 설정에서는 LTR을 껐습니다.
일정과 작업 방식
날짜는 모두 저장소 커밋 기록과 CHANGELOG의 Phase 기준입니다. 예상 일정은 따로 잡지 않았고 실제로 걸린 기간만 남겼습니다.
| 단계 | 시작 | 마지막 커밋 | 실제 한 일 |
|---|---|---|---|
| 문서 저장 | 2026-02-04 | 2026-02-14 | Spring Modulith CRUD, Flyway 스키마, 12,156,589건 데이터 적재, MySQL 버퍼풀·배치 튜닝 |
| 문서 색인 | 2026-03-02 | 2026-04-05 | Lucene NRT 색인, Kafka CDC 기반 색인 동기화, 재색인 파이프라인, n-gram 필드 튜닝 |
| 검색 | 2026-03-02 | 2026-03-30 | 검색 API, 캐시, 자동완성, 동의어·오타 교정, Facet, LTR, RAG |
| 분산 인프라 | 2026-03-18 | 2026-03-23 | Redis L2 캐시, MySQL 읽기·쓰기 분리, App 스케일아웃, Redis 샤딩 |
| 사용자 인터페이스 | 2026-02-04 | 2026-04-11 | Next.js 로그인·회원가입, 글쓰기 에디터, 카테고리 필터 UI |
| 문서화와 종료 | 2026-05-19 | 2026-05-19 | ADR 7건, ARCHITECTURE 문서 작성, 라이브 종료 반영 |
색인과 검색, 분산 인프라 단계는 날짜가 겹칩니다. Lucene으로 검색을 바꾼 뒤 캐시와 분산 구조로 옮겨갔다가 다시 검색 품질로 돌아와 동의어와 LTR을 붙이는 식으로 병목이 드러나는 순서를 따라갔기 때문입니다. 이후 2026년 8월 9일에 유지보수 커밋 1건이 있었습니다. 그 뒤로는 코드 변경이 없습니다.
직접 재 본 결과
수치는 모두 k6 부하 테스트나 실제 측정에서 나온 것이고 조건을 함께 남깁니다.
| 확인한 것 | 전 | 후 | 조건 |
|---|---|---|---|
| 본문 검색 | LIKE 5,000ms 이상 타임아웃 | BM25 29ms, P95 100ms | EXPLAIN rows=27,443,742 확인 후 전환 |
| 전체 응답(캐시) | 775.89ms | 53.83ms | Caffeine L1+Redis L2, 캐시 미스를 일부러 유도한 보수적 조건 |
| 분산 전환 후 부하(200 VU) | 에러율 13.25% | 에러율 0.09%, P95 190ms | 2 App + MySQL Replication + Redis 3샤드 + Kafka CDC |
| 검색 품질(NDCG@10) | 0.6910 | 0.7387 (+4.8%p) | LambdaMART 5-Fold 교차 검증 |
| LTR 켠 상태 부하(100 VU) | 검색 29.18ms | 검색 8,826ms | 2코어 ARM, rescore window 200, 이후 운영에서 비활성화 |
아직 못 한 것
- LTR 재랭킹은 코드에는 있지만 운영 설정에서는 꺼져 있습니다. 지금 서버 사양에서 CPU 비용이 검색 응답을 300배 가까이 늘립니다.
- 실제 다중 사용자 트래픽으로는 검증하지 않았습니다. 지금까지의 수치는 k6 부하 테스트(최대 200 VU)에서 나온 값입니다.
- 서비스는 2026년 5월 라이브를 종료했습니다. README와 ARCHITECTURE 문서에도 “운영합니다”를 “구성했습니다”로 고쳐 반영했습니다.
- 카테고리 자동 분류는 90건 수동 검증 기준 정확도 83%입니다. 경계에 있는 문서는 잘못 분류될 수 있습니다.
- Lucene 인덱스 동기화는 자동 shard 재분배가 없는 rsync와 Primary/Replica 방식입니다. 데이터가 크게 늘면 이 부분부터 다시 봐야 합니다.
직접 실행해 보기
Java 25, Gradle 9.3, MySQL 8.0, Redis 7.4가 필요합니다. Kafka는 CDC 기능에만 필요합니다.
git clone https://github.com/dj258255/wikiEngine.gitcd wikiEngine/backend./gradlew bootRun프론트엔드는 별도 터미널에서 실행합니다.
cd wikiEngine/frontendnpm installnpm run dev라이브 서버는 종료했기 때문에 Ansible 배포 절차는 저장소의 ansible/ 문서를 참고용으로만 남겨 뒀습니다.
더 보기
- 코드: GitHub 저장소
- 검색 엔진을 MySQL에서 Lucene으로 옮긴 전체 과정: Lucene 전환
- 검색 색인과 캐시를 DB 변경 기준으로 맞춘 과정: CDC 이벤트 기반 동기화
- 품질은 올랐지만 운영에서는 끈 재랭킹 모델의 전체 기록: LTR 재랭킹

댓글
댓글 수정/삭제는 GitHub Discussions에서 가능합니다.