모든 태그

# 실험 설계

3개의 글

수요를 가정으로 세우자 쌓아 둔 실측이 용량 모델로 읽혔다

커머스 백엔드의 공급 실측(모델 서버 처리량, DB 읽기·쓰기 무릎, 앱 홈 경로)은 문서마다 쌓여 있었지만 수요 모델이 없어 몇 배 모자란지 말할 수 없었다. MAU 10만 · 30만 · 100만 가정에서 peak RPS를 유도해 대조하자 첫 병목이 모델 서버로 드러났다. 1대 9.34/s는 MAU 약 7.5만에서 홈 수요가 넘어선다. 잠금 직렬 상한과 Little's Law 가 실측과 2% 안에서 맞는지 확인한 뒤 수평 확장 예측을 측정 전에 커밋했다. 2대 실측 15.15/s는 예측 범위 밖이었다. 법칙은 맞았고 서비스 시간을 상수로 둔 가정이 틀렸다. AWS 서울 온디맨드 환산 월 비용은 $903에서 $1,792이고 성장할수록 모델 서버 대수가 비용을 정한다.
GenPage는 순위 모델에 다섯 번 지고 비교 규칙을 맞춘 뒤 순위 점수와 합쳐 이기고 기본값이 됐다

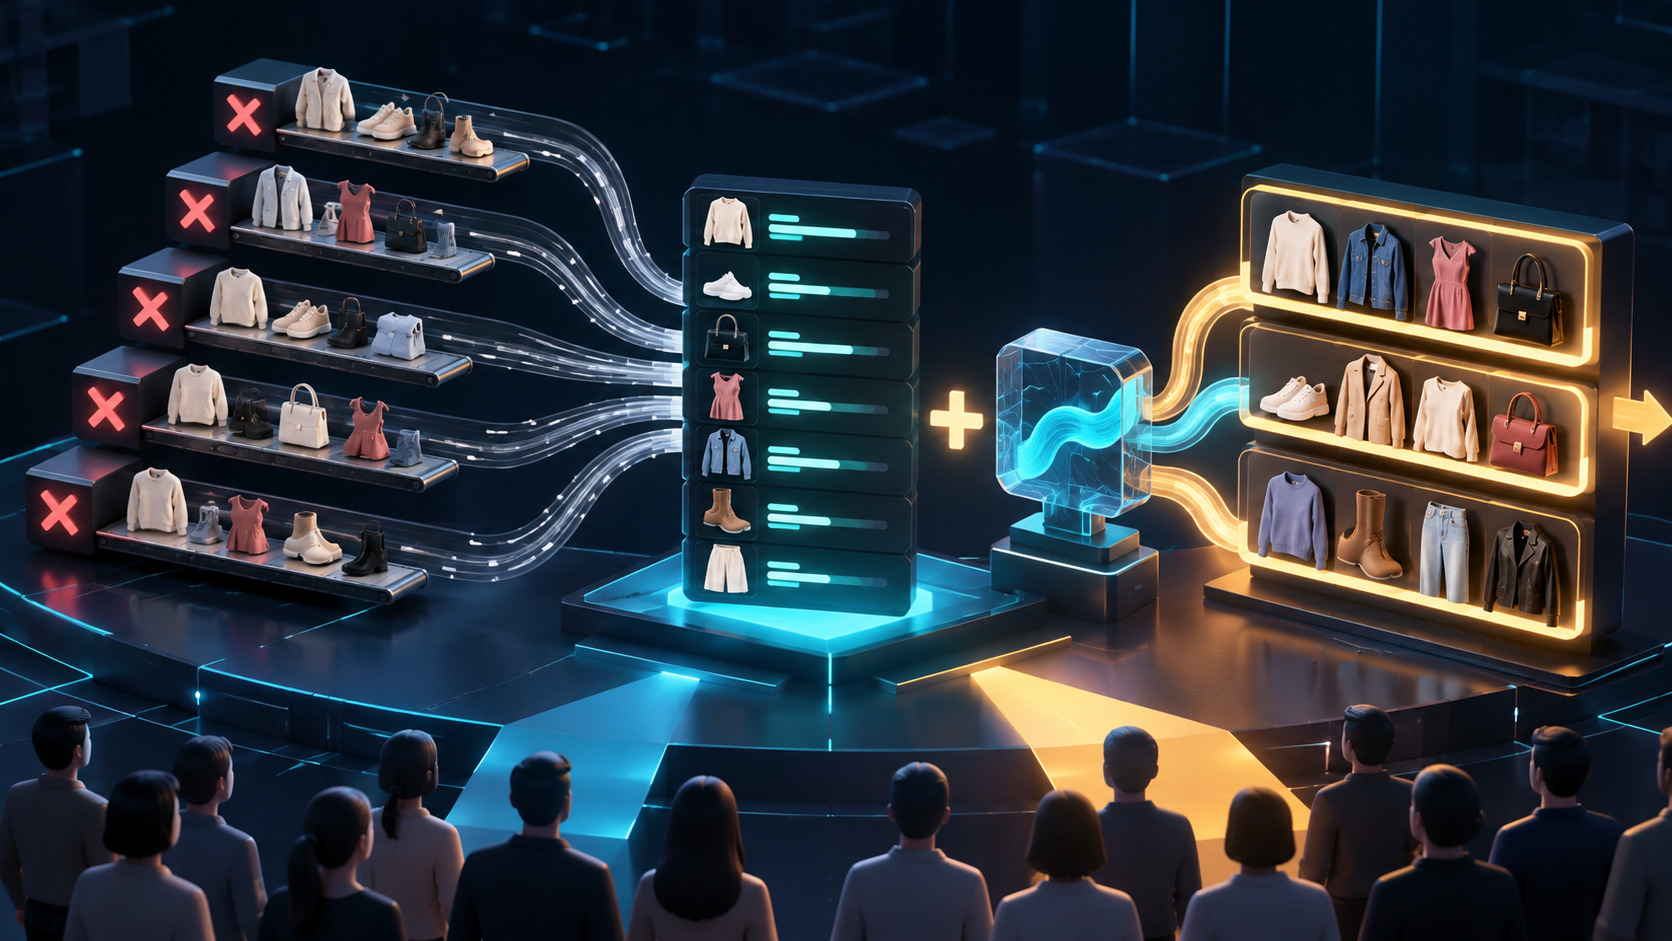
Netflix GenPage 구성을 H&M 구매 데이터로 옮겨 업계 표준(후보 생성 + LightGBM 순위 모델)과 겨뤘다. 상품 고르기, 줄 구성, Taobao 노출 데이터, 통계 곁채널, 행 점수 결합까지 다섯 번 모두 졌다. 비교 규칙을 두 쪽에 같게 걸고 순위 모델 점수 위에서 GenPage가 줄만 고르게 하자 홀드아웃 68,984명에서 규칙 줄 구성을 페이지 nDCG +2.0%로 이겼다. 그 방식을 모델 서버와 앱 홈 2쪽 기능 플래그로 붙였고 지연은 지금 방식보다 짧았다. 표본이 작아 판정을 내리지 못한 가상 사용자 A/B를 같은 사용자 68,984명 짝 설계로 다시 재자 구간이 16분의 1로 줄며 이겼다. 앱이 실제로 보여 주는 구성으로 재도 이겨서 홈 2쪽 줄 구성의 기본값을 결합 방식으로 켰다.

추천 모델을 학습해 보고 넣지 않았다: 넘을 선을 먼저 정했고 생성 중 차단도 재 보고 껐다

학습한 ALS 모델의 최고 점수(MAP@12 0.0076)는 측정 전에 정한 선(마지막 구매 재추천 0.0234)의 3분의 1이었고 인기 상품보다도 낮았다. 품절 상품을 생성 중에 막는 방식은 막으려던 문제가 실제 카탈로그에 없었고 서빙 중앙값을 62ms에서 369ms로 늘려 개인화를 못 받는 요청을 만들었다. 둘 다 코드는 남기고 켜지 않았다.