GenPage는 순위 모델에 다섯 번 지고 비교 규칙을 맞춘 뒤 순위 점수와 합쳐 이기고 기본값이 됐다
목차
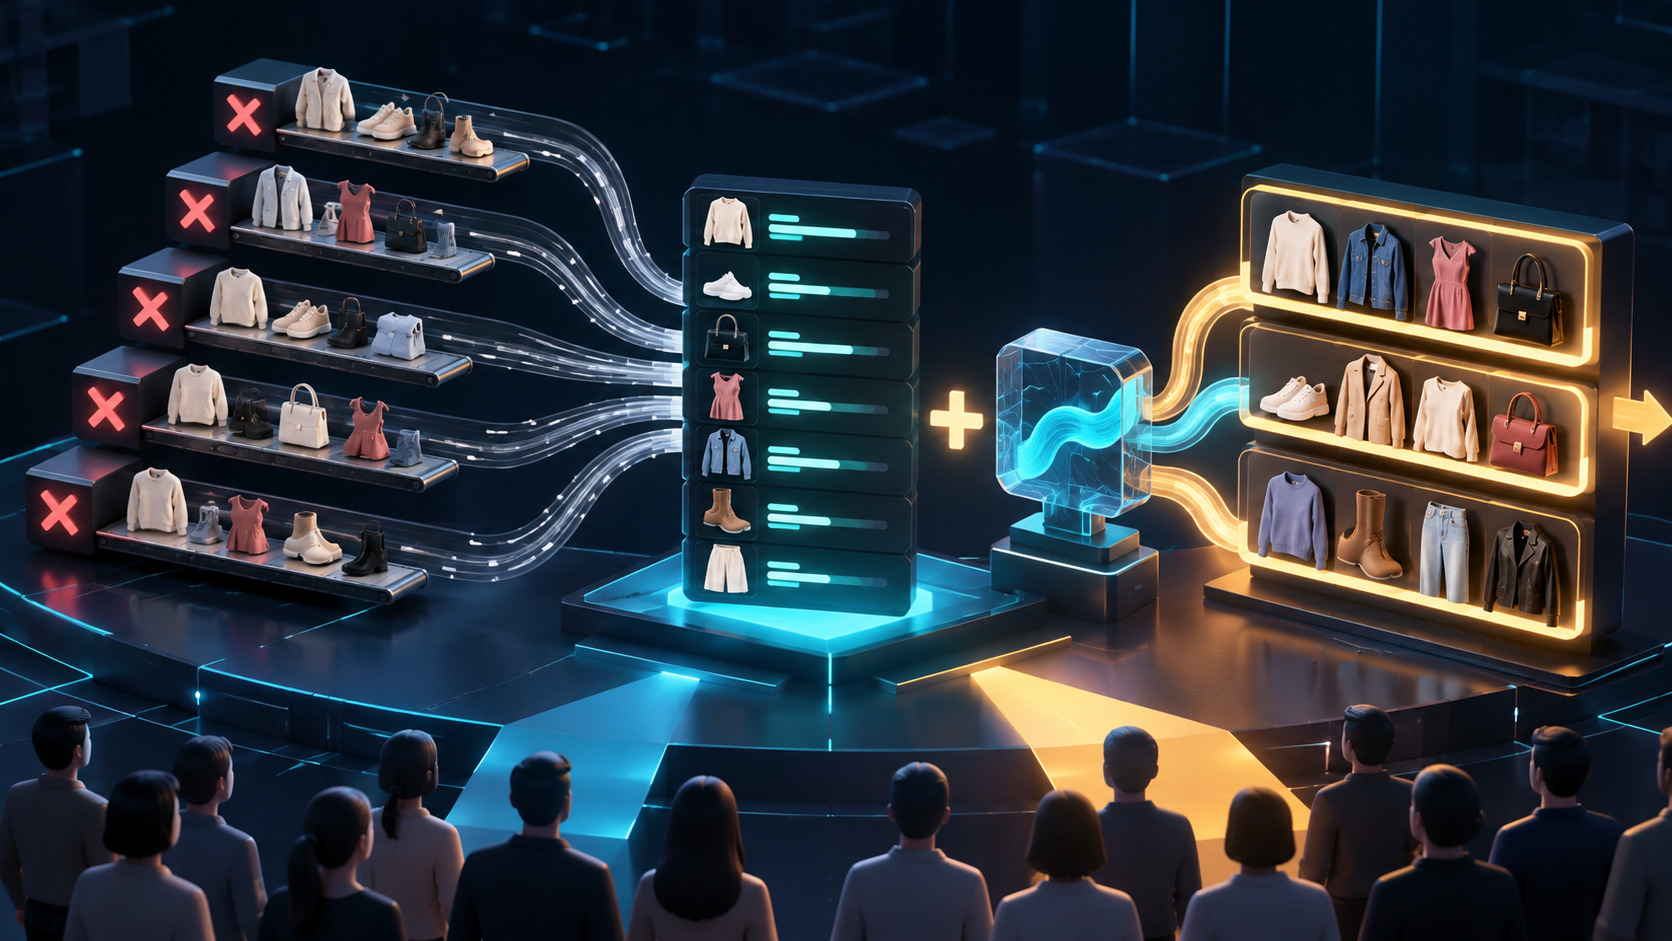
GenPage와 같은 계열의 생성·순차 모델로 업계 표준 순위 모델과 다섯 번 겨뤄 모두 졌습니다. 순위 모델이 매긴 점수 위에서 GenPage가 줄(행)의 구성과 순서만 정하게 하자 홀드아웃 고객 68,984명에서 규칙으로 짠 줄 구성을 페이지 nDCG 0.0564 → 0.0575(+2.0%, 95% 구간 [+0.0009, +0.0013])로 이겼습니다. Netflix는 순위 단계를 GenPage로 대신해 이겼고 여기서 이긴 방식은 순위 모델을 남겨 둔 채 그 점수를 GenPage에 더한 것이라 구조가 다릅니다. 그 방식을 모델 서버와 앱 홈 2쪽에 기능 플래그로 붙였습니다. 앱의 2쪽 응답 p95는 119ms로 지금 방식(125ms)보다 짧았습니다. 2,500명씩 나눈 가상 사용자 A/B는 판정을 내리지 못했지만, 같은 사용자 68,984명에게 두 방식을 다 보여 주는 짝 설계로 재자 실제 구매 적중 +0.0044 [+0.0030, +0.0058]로 이겼고 앱 구성 그대로 재도 이겨서 홈 2쪽 줄 구성의 기본값을 결합 방식으로 켰습니다.
개요
GenPage는 Netflix가 2026년 6월에 공개한 홈 페이지 생성 모델입니다. 사용자 이력을 프롬프트로 넣고 홈의 행(장르나 카테고리)과 그 안의 콘텐츠를 토큰 하나씩 생성합니다. Netflix는 운영 중인 행 · 콘텐츠 후보 집합 안에서 페이지를 생성했습니다. 후보 생성과 순위 모델을 여러 단계로 쌓은 기존 홈과 온라인 A/B를 해서 참여 지표 +0.24%와 응답 지연 20% 감소를 보고했습니다(arXiv 2606.31031).
이 프로젝트는 그 구성을 H&M 공개 거래 데이터로 옮겼습니다. 행은 H&M 상품 섹션과 “다시 사기” 행(고객이 산 적 있는 상품)이고 상품은 H&M 상품 번호입니다. 4,700만 파라미터 모델을 노트북 한 대에서 학습했습니다.
이 저장소의 질문은 무거운 모델이 요청 경로에 들어왔을 때 백엔드가 무엇을 보장해야 하는지입니다. 그 질문을 재려면 모델이 단순 규칙보다는 나아야 합니다. 그래서 측정 전에 비교 상대와 판정 규칙을 적고 그대로 판정했습니다. 판정은 같은 고객의 두 결과를 짝지어 2,000번 다시 뽑는 부트스트랩으로 차이의 95% 구간을 내고 구간 전체가 0 위면 이겼다고 봤습니다.
이 글의 숫자는 개인 프로젝트에서 공개 데이터로 잰 오프라인 값입니다. 실제 사용자 A/B는 없습니다.
상품 고르기에서는 순위 모델이 이겼다
비교 상대는 이 데이터의 공개 대회 상위 풀이와 같은 형태의 업계 표준입니다. 여러 출처에서 후보를 모은 뒤(최근 산 상품, 지난주 인기, 같은 섹션 인기, 의미가 비슷한 상품, 같이 산 상품) 특징 20여 개로 LightGBM 순위 모델을 학습합니다.
| 홀드아웃 68,984명 | 다음 주 구매 MAP@12 |
|---|---|
| 순위 모델 | 0.03456 |
| GenPage(같은 후보 안에서 생성) | 0.02140 |
| 마지막에 산 상품을 다시 보여 주는 규칙 | 0.02345 |
GenPage는 순위 모델에 졌고 단순 규칙에도 못 미쳤습니다(차이 구간 [−0.0139, −0.0125]). 순위 모델의 특징 중요도 상위는 고객이 그 상품을 산 횟수(16.1%), 상품의 어제 판매량(14.7%), 7일 판매량(10.6%)이었습니다. 순위 모델은 이런 카운트를 특징으로 바로 받고 GenPage는 토큰 순서에서 스스로 배워야 합니다.
줄 구성만 비교해도 졌다
Netflix는 홈 페이지 전체를 놓고 겨뤘습니다. 그래서 상품을 같게 두고 줄 구성만 바꿔 페이지끼리 다시 쟀습니다. 두 쪽 모두 순위 모델 점수 상위 200개 상품을 받아 6행 × 8개 페이지를 만듭니다.
- 규칙 줄 구성: 행마다 점수 상위 8개의 합이 큰 행부터 놓습니다
- GenPage 줄 구성: GenPage가 어떤 행을 몇 번째에 놓을지 생성하고 행 안은 점수 순입니다
주 지표는 페이지 nDCG입니다. 위쪽 행, 왼쪽 칸일수록 가중치가 큰 위치에 다음 주에 산 상품이 놓였는지를 잽니다. 결과는 0.0564 대 0.0369로 GenPage가 졌습니다. GenPage는 “다시 사기” 행을 거의 고르지 않았습니다(재구매 적중 0.0215, 규칙 0.0664).
노출 기록이 있는 데이터에서도 졌다
H&M에는 구매만 있습니다. Netflix는 “보여 줬는데 안 눌렀다”까지 학습했습니다. 이 차이를 재려고 Taobao 광고 노출 데이터(노출마다 클릭 여부와 시각이 있는 공개 데이터)로 옮겨 갔습니다. 고객의 노출 이력을 순서대로 읽는 순차 모델과 LightGBM 순위 모델을 같은 초에 함께 보인 광고 묶음 안의 클릭 순서(묶음 GAUC)로 비교했습니다.
| 시험 날 | 묶음 GAUC |
|---|---|
| 순위 모델 | 0.5760 |
| 순차 모델 | 0.5512 |
| 순차 모델에서 안 누른 노출을 지운 것 | 0.5457 |
| 광고의 전날 클릭률 하나 | 0.5518 |
순차 모델은 졌습니다(구간 [−0.0272, −0.0225]). 안 누른 노출 기록은 쓸모가 있었습니다. 지우면 0.0055 나빠졌습니다. 그래도 그 몫은 순위 모델과의 격차의 4분의 1이 안 됐고 순차 모델은 광고 클릭률 하나와 같은 점수에 머물렀습니다.
통계를 곁채널로 넣자 격차가 83% 줄었다
세 번의 패배에 공통점이 있었습니다. 순위 모델은 카운트와 클릭률 같은 통계를 받고 생성·순차 모델은 받지 못합니다. 쿠아이쇼우의 생성형 추천 OneRec도 재생 시간 같은 통계 특징을 아이템 토큰과 별도 경로로 넣는다고 보고합니다(arXiv 2506.13695).
같은 순차 모델에 순위 모델의 수치 특징 27개를 질의 쪽에 더했습니다. 묶음 GAUC가 0.5512에서 0.5717로 올라 순위 모델(0.5760)과의 격차가 0.0248에서 0.0043으로 줄었습니다. 그래도 구간 [−0.0061, −0.0026]으로 졌습니다.
H&M 쪽에서도 같은 방향을 시험했습니다. GenPage가 행을 고를 때 행 로그 확률에 순위 모델 행 점수(고객의 허용 행 안에서 표준화)를 λ배 더했습니다. 검증에서 λ=4를 골랐고 홀드아웃에서 0.0467 대 0.0564로 졌지만 격차는 절반이 됐습니다.
비교 규칙을 두 쪽에 같게 걸자 이겼다
λ를 키워도 재구매 적중이 0.027에서 움직이지 않았습니다. 행 선택 점수를 바꾸는데 특정 행이 늘지 않는다면 선택보다 후보 집합을 먼저 볼 일이었습니다. 세어 보니 원인은 측정 전에 정한 규칙이었습니다.
GenPage 쪽에는 “상위 200개 안에 상품이 8개 이상인 행만 허용”이라는 조건이 있었고 규칙 줄 구성에는 없었습니다. 고객이 산 상품은 보통 몇 개 안 돼서(검증 1만 명 중앙값 4개) 다시 사기 행을 놓을 수 있는 고객이 GenPage 쪽은 1,759명, 규칙 쪽은 7,391명이었습니다. 규칙은 측정 전에 적었지만 두 쪽에 다르게 걸렸습니다. 줄 구성 비교의 패배 일부는 이 비대칭에서 왔습니다.
허용 행과 행 안 상품을 규칙 줄 구성과 똑같이 두고 행을 고르는 방식만 다르게 해서 다시 쟀습니다.
| 홀드아웃 68,984명 | 페이지 nDCG | 페이지 적중 | 새 상품 적중 | 재구매 적중 |
|---|---|---|---|---|
| 규칙 줄 구성 | 0.0564 | 0.0973 | 0.0632 | 0.0664 |
| GenPage 행 선택 + 순위 모델 행 점수 | 0.0575 | 0.1003 | 0.0663 | 0.0662 |
차이는 +0.0011이고 구간은 [+0.0009, +0.0013]입니다. 페이지 적중, 새 상품 적중, 행 적중도 이겼고 앞 12개로 잰 MAP@12는 비겼습니다.
GenPage만 고르게 하면 검증에서 0.0338로 크게 졌습니다. 규칙을 풀어도 다시 사기 행을 1만 명 중 879명에게만 올렸습니다. 순위 모델 점수를 더하자 다시 사기 행이 규칙 수준(7,342명)으로 올라왔고 그 위에서 새 상품과 행 다양성 쪽 몫이 더해져 규칙을 넘었습니다. 무엇이 중요한지는 순위 모델이 알려 주고 줄의 구성은 생성 모델이 정하는 결합입니다.
| 단계 | 바꾼 것 | 홀드아웃 페이지 nDCG 차이 |
|---|---|---|
| 줄 구성 비교 | GenPage가 행을 고름 | −0.0195 |
| 행 점수 결합 | 순위 모델 행 점수를 더함 | −0.0097 |
| 규칙 대칭 | 허용 행 규칙을 같게 | +0.0011 |
서빙 경로에 붙였다: 오프라인과 같고 지금 방식보다 빠르다
순위 모델 점수는 배치로 고객마다 상위 200개를 미리 만들어 두고 요청이 오면 GenPage 서버가 그 점수로 줄을 짭니다. 모델 서버의 /page 요청에 compose(지금 방식 · 규칙 · 결합)와 고객 키를 더했습니다. 점수가 없는 고객은 지금 방식으로 만들고 응답에 대체 이유를 남깁니다. 줄 구성은 오프라인 평가가 쓴 함수를 서빙에서도 그대로 부릅니다.
- 홀드아웃 고객 500명의 서버 응답이 오프라인 페이지와 상품 순서까지 같았습니다(500/500)
- 서버 추론 p95는 결합 방식 142ms, 지금 방식 206ms였습니다. 결합 방식은 상품을 순위 모델 순서로 채우고 모델은 행 토큰만 고르기 때문에 생성할 토큰이 적습니다
- 점수가 없는 고객 81명은 지금 방식으로 대체됐고 오류는 0이었습니다
같은지 확인하다가 이력 정의가 달랐던 것을 찾았습니다. 오프라인 평가는 다시 사기 행을 정할 때 최근 100건 구매를 썼고 서빙 요청은 이벤트를 60건만 보냈습니다. 홀드아웃 고객의 32.6%가 이 차이로 다른 페이지를 받을 뻔했습니다. 모델 프롬프트는 최근 60건만 쓰므로 요청에 100건을 실어도 프롬프트는 같고 다시 사기 행 이력만 오프라인과 맞춰졌습니다.
앱 홈 2쪽에 기능 플래그로 붙였다
앱에는 회원과 H&M 고객을 잇는 매핑 표가 이미 있습니다. 설정 app.recommendation.genpage-compose(기본 OFF, RULE, HYBRID)를 켜면 홈 2쪽 요청에 고객 키를 싣습니다. 매핑 고객의 구매 이력은 H&M 거래 데이터에 있으므로 모델 서버가 고객 키로 이력 저장소를 읽습니다. 피처 저장소를 고객 키로 조회하는 구조와 같습니다.
| 앱 기본 설정(모델 타임아웃 300ms, 자리 공유) | 2쪽 p95 | 규칙 행으로 물러섬 |
|---|---|---|
| 지금 방식(OFF) | 124.7ms | 0% |
| 규칙(RULE) | 31.0ms | 0% |
| 결합(HYBRID) | 119.4ms | 0% |
- 매핑 계정 200개의 앱 2쪽이 같은 요청을 서버에 직접 보낸 응답과 같았습니다
- 매핑 없음, 점수 없음, 모델 서버 정지 세 경우를 계정 20개씩 보냈고 모두 응답 200, 오류 0이었습니다. 대체 이유는 지표 태그로 계정 수만큼 셌습니다
- 설정을 끄면 main 빌드와 같은 2쪽을 냈습니다(20/20)
붙이면서 두 가지가 드러났습니다. 서버의 결합 방식은 요청 행 수를 무시하고 항상 6행을 만들고 있었습니다. 서버만 6행으로 쟀을 때는 보이지 않다가 3행을 요청하는 앱을 붙이자 나왔습니다. 요청 값을 따르게 고쳤습니다. 앱은 상품이 3개 미만인 행을 화면에서 버립니다. 결합 방식의 다시 사기 행은 짧은 경우가 많아서 2쪽이 페이지당 2.57행(지금 방식 3.00행)이 됐습니다. 오프라인에서 이기게 한 짧은 행 일부가 화면에서 빠지므로 앱에서 효과를 다시 재려면 이 규칙부터 정해야 합니다.
가상 사용자 A/B는 표본이 작아 구간이 0을 걸쳤다
기본값으로 켜기 전 마지막 조건은 가상 사용자 A/B였습니다. 홀드아웃 구매 고객 5,000명을 둘로 나눠 한쪽은 규칙 줄 구성, 한쪽은 결합 방식을 보여 주고 실제 구매가 페이지에 있었는지를 쟀습니다.
결합 방식이 +0.0118 높았지만 구간이 [−0.0118, +0.0350]으로 0을 포함했습니다. 한쪽 2,500명으로 나눈 설계라 구간 반폭이 약 0.023이었습니다. 오프라인에서 이긴 크기(페이지 적중 +0.003)는 그 8분의 1이었습니다. 측정 전에 검정력을 계산하지 않아서 처음부터 가려낼 수 없는 크기였습니다.
같은 사용자에게 두 방식을 다 보여 주자 구간이 16분의 1로 줄었다
실제 서비스의 A/B는 한 사용자에게 한 방식만 보여 줄 수 있지만 시뮬레이션은 같은 가상 사용자에게 두 방식을 다 보여 줄 수 있습니다. 반응 난수가 고객과 날짜로 정해지므로 두 방식이 같은 난수를 씁니다. 사용자 사이의 우연이 차이에서 빠지고 방식의 차이만 남습니다.
홀드아웃 구매 고객 68,984명 전원에게 규칙 줄 구성과 결합 방식을 차례로 보여 주고 사용자 단위 짝 부트스트랩 2,000회로 구간을 쟀습니다.
| 68,984명 짝 | 규칙 줄 구성 | 결합 방식 | 차이 | 95% 구간 |
|---|---|---|---|---|
| 실제 구매 적중(주 지표) | 0.2252 | 0.2296 | +0.0044 | [+0.0030, +0.0058] |
| 실제 구매 적중(3개 미만 행 제거) | 0.2130 | 0.2181 | +0.0051 | [+0.0038, +0.0065] |
구간 반폭이 0.023에서 0.0014로, 16분의 1로 줄었습니다. 2,500명씩 나눈 비교에서 +0.0118로 보이던 차이는 사용자 무리 사이의 우연이 섞인 값이었습니다. 같은 사용자의 차이로 재자 오프라인에서 이긴 크기와 같은 자릿수(+0.0044)로 돌아왔습니다. 시뮬레이터가 내는 구매율은 −0.0003으로 반대 방향이었는데, 이 반응 모델은 앞 비교에서도 실제 구매와 어긋난 적이 있어 판정은 실제 구매 기준 주 지표로만 했습니다.
앱이 실제로 보여 주는 구성으로 재도 이겨서 기본값을 켰다
남은 걱정은 화면 규칙이었습니다. 앱 홈 2쪽은 3행 × 8개이고 상품 3개 미만 행을 버립니다. 결합 방식의 다시 사기 행은 짧은 경우가 많아 이기게 한 행이 화면에서 빠질 수 있었습니다. 그래서 같은 68,984명 짝을 앱 구성 그대로(3행 × 8개, 두 쪽, 2쪽은 1쪽 상품 제외) 다시 재고, 주 지표도 행을 버린 뒤의 실제 구매 적중으로 바꿨습니다. 판정 기준은 측정 전에 적어 두었습니다.
| 68,984명 짝 · 3행 × 8개 | 규칙 줄 구성 | 결합 방식 | 차이 | 95% 구간 |
|---|---|---|---|---|
| 3개 미만 행 제거 후 실제 구매 적중(주 지표) | 0.1750 | 0.1799 | +0.0049 | [+0.0039, +0.0059] |
| 실제 구매 적중(버리기 전) | 0.1836 | 0.1879 | +0.0043 | [+0.0034, +0.0053] |
행을 버린 뒤에도 이득이 그대로였습니다(+0.0049). 요청 실패와 대체는 0이었습니다.
측정 전에 적은 판정대로 앱 설정 app.recommendation.genpage-compose의 기본값을 OFF에서 HYBRID로 바꿨습니다. 모델 서버가 죽거나 매핑 · 점수가 없는 고객은 지금 방식으로 자동으로 물러납니다. 되돌리기는 환경변수 한 줄입니다. 근거가 오프라인 평가와 가상 사용자 짝 A/B라는 한계는 결정 기록(ADR-079)에 그대로 남겼습니다. 실제 사용자 A/B가 아니기 때문입니다.
정리
- 생성·순차 모델만으로는 상품 고르기, 줄 구성, 노출 데이터 세 비교에서 모두 순위 모델에 졌습니다. 공통 원인은 순위 모델이 쓰는 통계를 받지 못한 것이었고 통계를 곁채널로 넣자 격차의 83%가 사라졌습니다
- 순위 모델 점수 위에서 GenPage가 줄을 고르게 하자 규칙 줄 구성을 오프라인에서 +2.0% 이겼습니다. Netflix는 순위 단계를 GenPage로 대신해 이겼고 여기서는 순위 모델을 남긴 채 결합해야 이겼습니다
- 측정 전에 규칙을 적어도 두 쪽에 다르게 걸리면 결론이 바뀝니다. 줄 구성 비교의 −0.0195 중 일부는 그 비대칭에서 왔습니다
- 서빙과 앱 경로에 붙였을 때 지연은 지금 방식보다 짧았고 대체 경로는 모두 동작했습니다
- 2,500명씩 나눈 가상 A/B는 검정력이 없어 판정하지 못했습니다. 같은 사용자 68,984명에게 두 방식을 다 보여 주는 짝 설계로 재자 구간이 16분의 1로 줄며 이겼습니다. 앱이 실제로 보여 주는 구성으로 재도 이겨서 기본값을 결합 방식으로 켰습니다
근거 문서: 저장소의 personalization/docs/genpage-v2/STATUS.md(D2 ~ D5), T1-TAOBAO.md · T2-TAOBAO-FEATURES.md, BACKEND.md(S1 ~ S4), docs/adr/ADR-079-genpage-hybrid-default-on.md(기본값 결정), ADR-068-genpage-v2-not-default.md(그 전까지 기본값을 껐던 근거).

댓글
댓글 수정/삭제는 GitHub Discussions에서 가능합니다.