AI를 켤 곳과 끌 곳을 가르는 기준
목차
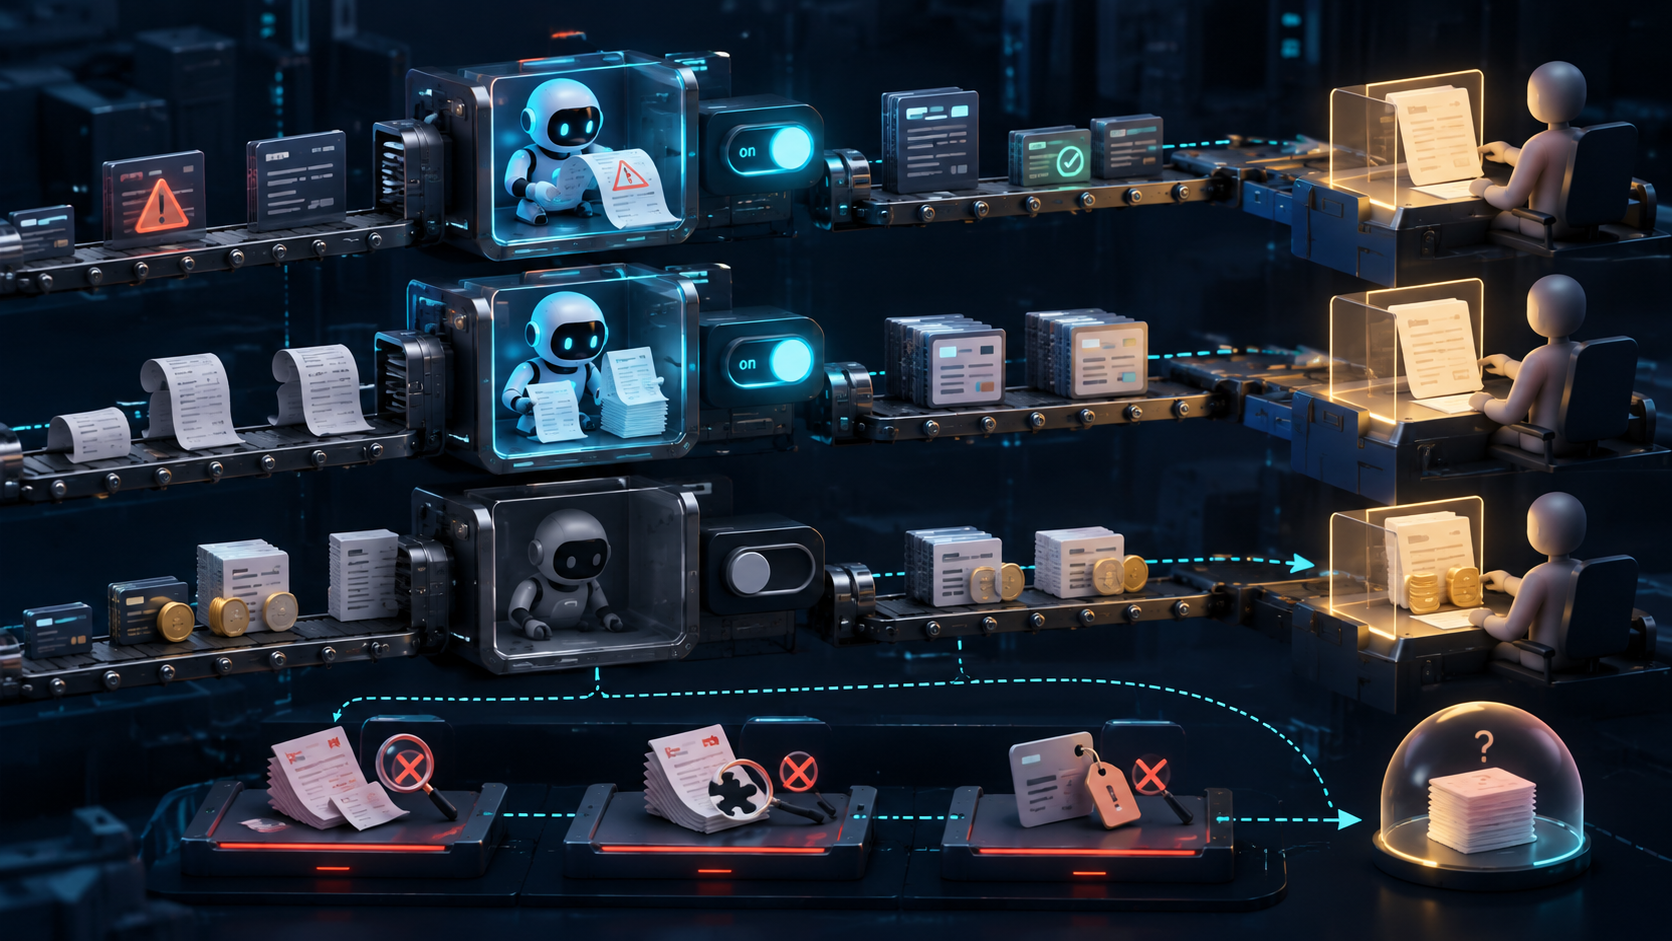
결제 시스템의 운영 업무 세 곳에 로컬 LLM을 붙여봤습니다.
- 장애 로그의 원인 진단
- 여러 기록을 모은 운영자용 요약
- 대사 불일치의 원인 분류
처음에는 모델의 정확도가 충분하면 켜면 된다고 생각했습니다. 같은 12건에서 규칙은 7건 적중·5건 기권·0건 오답, qwen3:8b는 11건 적중·1건 오답이었습니다. 숫자만 보면 규칙을 모델로 바꾸면 됩니다.
그렇게 하지 않았습니다.
| 자리 | 어떻게 했나 | 결과 |
|---|---|---|
| 장애 로그 진단 | 규칙이 아는 7건은 규칙, 규칙이 기권한 5건만 모델 | 켬 |
| 운영자용 요약 | 모델이 금액을 빠뜨리면 폐기하고 템플릿으로 복귀 | 켬 |
| 대사 원인 분류 | 규칙이 못 푸는 문제를 찾았지만 그 문제도 규칙으로 설명됨 | 끔 |
세 곳에서 내린 결정은 달랐지만 기준은 같았습니다. “모델이 얼마나 잘하나”보다 “기존의 결정적인 방법이 못 하는 어떤 일을 모델에게 맡길 수 있나” 를 봤습니다. 모델을 켠 두 자리에서도 그 판단으로 결제를 확정하거나 대사를 닫게 하지는 않았습니다. 최종 확정은 셋 다 사람이 합니다.
그 기준을 정하는 과정에서 평가 장치도 세 번 틀렸습니다. 로그에 정답을 흘려 모델 점수를 부풀렸고, 숫자 결손 검사기는 17,300과 173,000을 구분하지 못했으며, 마지막 한 건은 모델이 아니라 제가 붙인 정답이 틀렸을 가능성이 남았습니다. 모델뿐 아니라 모델을 평가하는 코드와 정답까지 검증 대상이 됐습니다.
결론부터
- 규칙이 확정적으로 처리할 수 있는 일은 모델에 넘기지 않았습니다.
- 규칙이 기권한 장애 로그는 모델을 보조로 사용하되, 최종 판단은 사람에게 남겼습니다.
- 운영자용 요약은 금액·날짜의 출처를 검증한 뒤 사용했지만, 대사 원인 분류는 모델이 추가 가치를 만들지 못해 껐습니다.
모델을 켜는 기준은 정확도 하나가 아닙니다. 기존 방법이 못 하는 일을 맡길 수 있는지, 실패했을 때 되돌릴 폴백이 있는지, 최종 권한을 사람이 유지하는지를 함께 봐야 합니다.
첫 번째 자리: 규칙이 기권한 장애만 모델에게 맡겼다
장애 로그 진단은 원래 “표본이 얇다”는 이유로 켜지 않기로 한 기능이었습니다. 처음 실험 로그는 4건이었는데 3건에서 4건으로 늘리는 것만으로 규칙과 모델의 우열이 바뀌었고, 대사 원인 분류에서도 손으로 만든 27건이 실제 유입과 달라 결론이 뒤집혔습니다.
IncidentLogCaptureTest가 진짜 장애를 내고 그때 찍힌 로그를 파일로 받아 적습니다.
| 표본 | 실제로 한 일 | 로그 문장을 낸 주체 |
|---|---|---|
RACE_CONDITION-01 | 두 커넥션이 같은 두 행을 반대 순서로 FOR UPDATE | MySQL이 낸 SQLState 40001, Deadlock found |
RACE_CONDITION-03 | 행을 잡고 놓지 않은 채 innodb_lock_wait_timeout=3 | MySQL이 낸 Lock wait timeout exceeded |
DB_TIMEOUT-02 | 풀 크기를 1로 두고 커넥션을 물고 안 돌려줌 | HikariCP가 낸 Connection is not available |
REPLICATION_LAG-01 | 30초 지연을 건 진짜 MySQL 복제본에서 조회 | 앱: 커밋했는데 조회 0건, 35초 뒤 1건 |
나머지 네 건은 각주로 뺍니다.¹
¹ RACE_CONDITION-02 다른 스레드가 version을 계속 올려 WHERE version=N이 0행을 맞게 함(앱: 영향 행 0건, 재시도 소진) · CERT_EXPIRY-01 실제로 만료된 인증서를 쓰는 호스트에 붙음(JDK: CertificateExpiredException: NotAfter ... 2015) · PG_UNAVAILABLE-02 죽은 포트로 승인 요청 3회(JDK: ClosedChannelException) · PG_UNAVAILABLE-03 503을 내는 서버를 띄워 3회 호출(앱: 응답 503과 본문).
정답이 틀린 표본은 코퍼스를 오염시키므로, MySQL 컨테이너를 더 띄워 CHANGE REPLICATION SOURCE TO ... SOURCE_DELAY=30으로 30초 지연을 걸고 커밋 직후 0건·35초 뒤 1건을 확인해 다시 만들었습니다. 4건이 12건(유형당 1~3건)이 됐습니다.
규칙을 앞에 두고, 기권한 자리에만 모델을 부릅니다
12건에 규칙과 모델을 나란히 태우고 4회 반복했는데 매번 같은 숫자, 같은 틀린 건이었습니다.
rule 맞음 7 · 기권 5 · 틀림 0ollama:qwen3:8b 맞음 11 · 기권 0 · 틀림 1ollama:qwen3:8b + 근거 대조 맞음 11 · 기권 0 · 틀림 1모델이 4건 앞서지만 성격이 다릅니다. 규칙은 아는 패턴에만 답하고 한 번도 틀리지 않았고, 모델은 모르는 것에도 답하고 틀린 답에도 근거를 붙입니다. 모델로 통째로 바꾸면 규칙이 답하던 7건까지 모델의 오답 위험에 들어갑니다.
public Optional<IncidentDiagnosis> diagnose(String logText) { Optional<IncidentDiagnosis> byRule = rule.diagnose(logText); if (byRule.isPresent() && byRule.get().cause() != IncidentCause.UNKNOWN) { return byRule; } Optional<IncidentDiagnosis> byModel = model.diagnose(logText); if (byModel.isPresent() && !grounding.grounded(byModel.get(), logText)) { return Optional.empty(); // 인용이 원문에 없으면 버린다 } return byModel;}이 구성은 11건을 맞히고 1건을 틀렸습니다. 점수는 같지만 규칙이 답한 7건은 모델을 거치지 않으므로 기본값을 여기로 옮겼습니다. 대가는 답마다 출처를 구분해 내보내는 비용입니다.
public record IncidentDiagnosis(IncidentCause cause, String evidence, Source source) { public enum Source { RULE, MODEL }
/** 출처를 안 밝히면 모델로 본다. 덜 믿는 쪽이 기본값이어야 합니다. */ public IncidentDiagnosis(IncidentCause cause, String evidence) { this(cause, evidence, Source.MODEL); }}첫 11/12는 믿을 수 없는 숫자였다
첫 캡처 결과는 모델이 규칙보다 4건 앞선 것이었습니다. 그대로 쓸 뻔했는데, 제가 앱 로그에 진단명을 찍고 있었습니다.
재고 차감 낙관적 락 충돌 — 1회차 재시도 (version=0 이 이미 바뀜)복제 지연 0초 — 조회가 없다고 답한 것은 행이 없어서가 아니다“낙관적 락 충돌”과 “복제 지연”은 제가 붙인 이름입니다. 모델은 그 문구를 읽고 맞히고, 규칙은 제가 지어낸 한국어 문구를 패턴에 없으니 기권합니다. 앱이 찍는 줄을 관측된 사실까지 낮추고 진단명은 MySQL·JDK가 스스로 낸 문장에만 남긴 뒤 다시 쟀더니 결과가 같았습니다.
마지막 한 건은 모델이 아니라 내 라벨이 틀렸을 수 있다
코퍼스의 정답은 제가 알고 붙인 라벨이고, 그 라벨을 세 번 틀렸습니다. 첫째, 복제 지연을 커밋하지 않은 트랜잭션으로 만들었다가 지웠습니다. 둘째, Lock wait timeout exceeded를 DB_TIMEOUT으로 붙였다가 RACE_CONDITION으로 고쳤습니다. 셋째는 아직 확정하지 않았습니다.
2026-09-05T08:29:44 INFO WebhookService : 웹훅이 결제보다 먼저 도착 — 보류 retry=62026-09-05T08:29:49 INFO WebhookService : 웹훅이 결제보다 먼저 도착 — 보류 retry=7...2026-09-05T08:30:19 WARN WebhookPendingScheduler : 웹훅 보류 재시도 소진 webhookEventId=3제 라벨은 QUEUE_BACKLOG이고 모델은 매번 RACE_CONDITION이라고 답했습니다. 로그 첫 줄이 “웹훅이 결제보다 먼저 도착”이니 순서가 꼬인 쪽에 더 가깝습니다. 모델이 맞다면 실제 성적은 12건 중 12건이고 유일한 오답은 제 라벨입니다.
그렇다고 지금 라벨을 고치면 모델에 유리하게 기준을 고치는 것이 되므로, 이 1건은 “오답”이 아니라 “라벨 재검토” 로 확정하고 성적표에는 11건 적중(+1 라벨 재검토) 으로 적습니다. 다른 자리에서 기준을 표본을 보고 고쳤다가 91%가 100%가 된 적이 있어, 이번엔 판정을 미루는 쪽을 택했습니다.
그 수치가 사실인지도 회귀한다
절대 임계 대신 회귀를 봅니다. 틀린 수는 부호를 뒤집어 저장하고 5% 안쪽은 흔들림으로 넘기며, 기준선이 없으면 만들고 통과시키고 갱신은 사람이 합니다. corpusFingerprint도 남깁니다.
"context": { "model": "ollama:qwen3:8b", "samples": "12", "corpusFingerprint": "20460f8c" }ruleFirst.correct: 12.000 → 11.000(바뀜) model: ollama:qwen3:14b → ollama:qwen3:8b두 번째 자리: 실패해도 템플릿으로 돌아오게 만든 뒤 켰다
운영자용 요약은 같은 사실로 템플릿 문단과 모델 문단을 만들어 사람이 고르게 하는 장치였는데, 표본이 0건이었습니다. 생성은 qwen3:8b, 심판은 계열이 다른 llama3.1:8b였습니다.
템플릿 0 · 모델 0 · 동점 8 (그중 순서 뒤집힘 8)심판이 고른 것은 요약의 질이 아니라 앞에 놓인 쪽이었습니다. 문헌의 위치 편향은 순서만 바꿔도 최대 30%가 반전되고 평균 order-flip이 0.236인데 우리는 100%(8건)였습니다. 프롬프트에 A/B 자리 표시가 남아 있어 내용보다 자리를 먼저 읽었을 가능성이 큽니다(추정).
케이스 모양을 넷으로 갈라 30건을 새로 뽑아, 이 코드를 같이 작성한 Claude에게 다시 물었습니다(중립적이지 않습니다).
출처 선호 템플릿 4 · 모델 26 (26/30, 단측 p = 0.00003)위치 선호 A 18 · B 12 (18/30, 단측 p = 0.18) 모델이 A 자리일 때 모델을 고른 비율 15/16 모델이 B 자리일 때 모델을 고른 비율 11/14“모델 심판으로는 이 차이를 못 가린다”는 건 모델 크기 문제였습니다. 그런데 이 26대 4를 승격 근거로 쓸 수는 없습니다. 템플릿 출력이 주문 ORD-B000 — 2026-06-01 · ORDER · 주문 생성 10,000원 그다음 ...처럼 “그다음”으로 이어 붙인 사슬이라 심판은 어느 쪽이 템플릿인지 알고 읽었고, 블라인드가 깨진 선호는 자기선호 편향과 구별되지 않습니다.
결손을 잡으라고 만든 검사기가 결손을 통과시켰다
30건을 읽다가 편향과 무관한 차이를 봤습니다. 모델이 금액을 빠뜨린 건이 있었습니다.
2026-06-14에 대사 상태가 AMOUNT_MISMATCH로 변경되어 내부 기록과 외부 기록의 금액이 다름을 나타냈습니다.
내부가 얼마고 외부가 얼마인지가 없습니다. 금액 없는 요약은 대사 불일치를 조사하는 사람에게 그 자리에서 쓸모가 없고, 취향이 아니라 빠진 것이므로 셀 수 있습니다. 사실 묶음의 금액이 남았는지 세는 검사기의 초기 구현이 이랬습니다.
private boolean mentions(String text, long amount) { return text.contains(NumberFormat.getNumberInstance(Locale.KOREA).format(amount)) || text.contains(Long.toString(amount));}contains("17300")은 173000 안에서도 참이고 "17,300"은 117,300 안에서도 잡힙니다. 엉뚱한 금액이 결손을 덮어 주고, 막는 쪽이 아니라 통과시키는 쪽으로 틀렸습니다.
private boolean standalone(String text, String needle) { return Pattern.compile("(?<![\\d,])" + Pattern.quote(needle) + "(?!\\d|,\\d)") .matcher(text).find();}경계를 좁히기만 하면 반대 실수가 납니다. 템플릿 출력의 "외부 17,300, 내부 기록 없음"처럼 자릿수 구분이 아닌 쉼표가 금액 뒤에 오는 자리는 통과시키면서 17,300,000은 막아야 합니다. 고친 뒤 템플릿 30건 모두 결손 0을 확인했습니다.
간헐적 결손은 오프라인으로 못 막는다
고친 검사기로 여섯 번 쟀습니다.
template 0/30 (여섯 번 모두)ollama:qwen3:8b 4 · 0 · 1 · 0 · 1 · 2 / 30겹치는 건을 합치면 서로 다른 결손은 다섯 건이고 그중 넷이 “외부에만 있음” 건이었습니다. 결제사는 처리했다는데 우리 장부에는 없는 건이고, 사실이 네 개뿐이라 짧을수록 숫자를 버립니다. 같은 코드로 0건이 나오는 회차와 4건이 나오는 회차가 섞이므로, 오프라인에서 0이 나와도 다음 호출에서 빠뜨립니다. “금액을 안 빠뜨린다”는 평가로 증명할 수 없습니다.
AmountCoverageGuard를 붙였습니다. 출처 검증기와 방향이 반대입니다. 출처 검증은 없는 숫자를 지어냈는지, 이 가드는 있는 숫자를 버렸는지 봅니다. 둘 다 통과해야 요약이 나가고 버린 건은 dropped_amounts로 지표와 감사 기록에 남습니다. 실험용 판정기를 따로 만들면 둘이 갈려 실험 결과가 운영에 대해 아무 말도 못 하므로, 운영에서 도는 그 가드를 그대로 씁니다.
버린 요약을 빈 화면에 두려던 것을 바꿨습니다
버린 요약을 어떻게 하는지는 안 봤는데, 코드는 버리면 Optional.empty()를 돌려줘 운영자 화면이 통째로 비었습니다. 결손은 30건 중 0~4건으로 간헐적이니 모델을 켜면 그 확률로 요약이 아예 없는 화면을 보고, 템플릿은 늘 뭔가를 냅니다. 어느 쪽이 잘 읽히는지를 재기 전에 이미 켜면 안 되는 상태였습니다.
버렸을 때 템플릿으로 떨어뜨렸고 폴백도 같은 가드를 통과해야 나갑니다. 기권한 자리에서도 떨어뜨립니다. 원래는 기권하면 비웠고 근거가 “억지로 만든 문장은 일을 늘린다”였는데, 그 근거는 모델에게 억지로 쓰게 하는 것에 대한 것이지 사실을 그대로 옮기는 템플릿에는 해당하지 않습니다.
그래서 켰습니다. 근거가 “더 낫다”가 아니라, 모델을 켠 최악이 템플릿을 켠 것과 같아졌으므로 못 잰 것이 위험으로 남지 않습니다. 품질은 못 닫았습니다. 사람이 고른 표본은 0건이고, 사람 선호 평가 문헌은 50건이면 충분하다지만 그 기준은 제가 만든 것이라 영영 안 닫히는 상태가 됐습니다. 그래도 하나는 바뀌었습니다. 사람이 고를 때 금액이 빠진 요약은 후보에 올라오지 않으므로, 그 결손을 “모델이 못 쓴다”의 근거로 잘못 세지 않게 됐습니다.
세 번째 자리: LLM을 넣으려다 규칙의 구멍을 찾아서 안 켰다
껐던 자리(대사 원인 분류)를 다시 봤습니다. 켤 유형을 넓히려면 규칙이 못 내는 원인이어야 합니다. 규칙 분류기가 낼 수 있는 값은 아홉 종이고(다른 편에서 “대사 원인 8종”이라 부른 여덟 원인에 “그 밖”을 더한 값), 그중 규칙이 실제로 내는 것은 일곱이었습니다.
규칙이 내는 것 수수료 차이 · 부분취소 미반영 · 시간대 경계 · PG 파일 지연 망취소 타이밍 · 내부 기록 유실 · 위변조 의심규칙이 못 내는 것 중복 기록 · 그 밖“그 밖”은 모델 금지 목록이라 남는 것은 중복 기록 하나였는데, 그 자리도 모델의 자리가 아니었습니다. 대사 엔진의 결과 유형은 넷뿐이고 중복 기록은 별도 유형으로 오지 않고 외부가 내부의 정수배인 금액 불일치로 나타납니다.
넣기 전에 그 건들이 어디로 가고 있었는지 봤습니다. 금액 불일치 규칙은 수수료도 취소도 아니면 마지막 갈래에서 위변조 의심을 붙입니다. PG 파일에 같은 줄이 두 번 실린 평범한 운영 사고에 위변조 딱지가 붙고 있었습니다. 확인하는 사람은 매번 그 의심부터 배제해야 합니다.
if (internal > 0 && diff < 0 && (-diff) % internal == 0) { long times = (-diff) / internal + 1; out.add(CauseSuggestion.likely(ResolveCause.DUPLICATE_RECORD, ...));}결정적이 아니라 유력으로 냈습니다. 같은 주문에 결제가 실제로 두 번 일어났는데 우리 쪽에 한 건만 남은 경우도 숫자가 똑같아 그 둘은 산수로 안 갈리므로 사람이 봐야 합니다. 중복으로 설명되면 위변조 의심을 함께 내지 않습니다.
넓힐 후보가 하나 있었고 그것도 규칙의 몫이었습니다. 이 자리에서 모델이 규칙보다 나은 구간을 아직 못 찾았고, 찾으면 그때 켭니다.
남은 것
CONFIG_DRIFT는 아직 표본이 0건입니다.- 모델 하나(
qwen3:8b)로만 쟀습니다. 모델을 바꿔도 성립하는지는 모릅니다. - 근거 대조 가드가 그 1건(라벨 재검토)을 막지 못했습니다. 인용은 진짜인데 결론만 틀린 실패는 여전히 안 걸러집니다. 같은 벽을 세 번째 만났습니다.
- 운영자용 요약이 템플릿보다 나은지는 모르는 것으로 뒀습니다. 사람이 고른 표본이 생기면 심판과의 일치도부터 재고, 그때 처음으로 품질을 말합니다.
- 제재 명단 대조와 가맹점 단위 정산은 제재 명단 편·정산 공정성 편에서 다룹니다.
마무리
LLM을 켜는 기준을 정확도 하나로 잡지 않았습니다. 규칙이 확실히 답할 수 있는 곳에서는 규칙을 남겼고, 모델이 실패해도 기존 방식으로 돌아갈 수 있는 곳에서는 모델을 켰으며, 규칙으로 설명할 수 있는 문제가 남아 있는 곳에서는 모델을 켜지 않았습니다.
이어서 읽기
이 글에서 이어진 작업은 따로 적었습니다.
참고
- 심판 모델의 위치 편향: Judging the Judges (arXiv 2406.07791)
- 인간 선호 평가에 필요한 표본 수: How Many Human Judgments Are Enough? (arXiv 2601.09084)
- 상담원 보조로 둔 LLM: Stripe의 지원 응답 시스템 (ZenML LLMOps Database)
- 사람과 AI 협업으로 처리량을 올린 사례: Intercom Fin Copilot
- 사내 업무 도우미 도입에서 보안이 가장 어려웠다는 기록: 카카오페이 페이증권 업무도우미
- LLM 기반 근본원인 분석 벤치마크: PRAXIS (arXiv 2512.22113), Traversal 벤치마크
- 공개 포스트모템 분류: post-mortems

댓글
댓글 수정/삭제는 GitHub Discussions에서 가능합니다.