AI를 켤 곳과 끌 곳을 가르는 기준
결제 운영 자동화 세 곳에서 모델을 켜고 끈 기준. 장애 로그 진단과 운영자용 요약은 켰고 대사 원인 분류는 껐다. 그 과정에서 평가 장치도 세 번 틀렸고, 마지막 한 건은 모델이 아니라 제 라벨이 틀렸을 가능성으로 남겼다.
검색 결과가 없습니다
제목, 태그, 카테고리로 검색
결제 운영 자동화 세 곳에서 모델을 켜고 끈 기준. 장애 로그 진단과 운영자용 요약은 켰고 대사 원인 분류는 껐다. 그 과정에서 평가 장치도 세 번 틀렸고, 마지막 한 건은 모델이 아니라 제 라벨이 틀렸을 가능성으로 남겼다.
규칙이 설명하지 못한 대사 예외에 모델을 붙였지만, 실제 잔여 분포에서 규칙 분류기와 같은 답을 냈다. 개발 표본의 91~100%만 보고 자동화를 켜지 않고, 홀드아웃에서 개선이 0임을 확인한 뒤 기본값을 규칙으로 유지한 이유를 정리한다.
결제 상담 초안을 자동 채점하는 루브릭이 평균 4.97/5점을 줬지만, 사람이 블라인드로 쓴 답과 비교하니 편집 거리 중앙값이 45.6%였다. 루브릭을 조이면 정상 문장을 놓치고, 고객 영향을 요구하면 모델이 모르는 것까지 단언했고, 다른 계열 심판도 틀렸다.
모델을 붙이기 전에 포트와 숫자 검증기부터 만들었다. 실제 데이터를 넣자 검증기가 분류기가 계산한 진짜 270원을 출처에 없다며 반려했고, 고친 뒤에도 반복 실행에서만 드러나는 결함이 둘 더 나왔다.
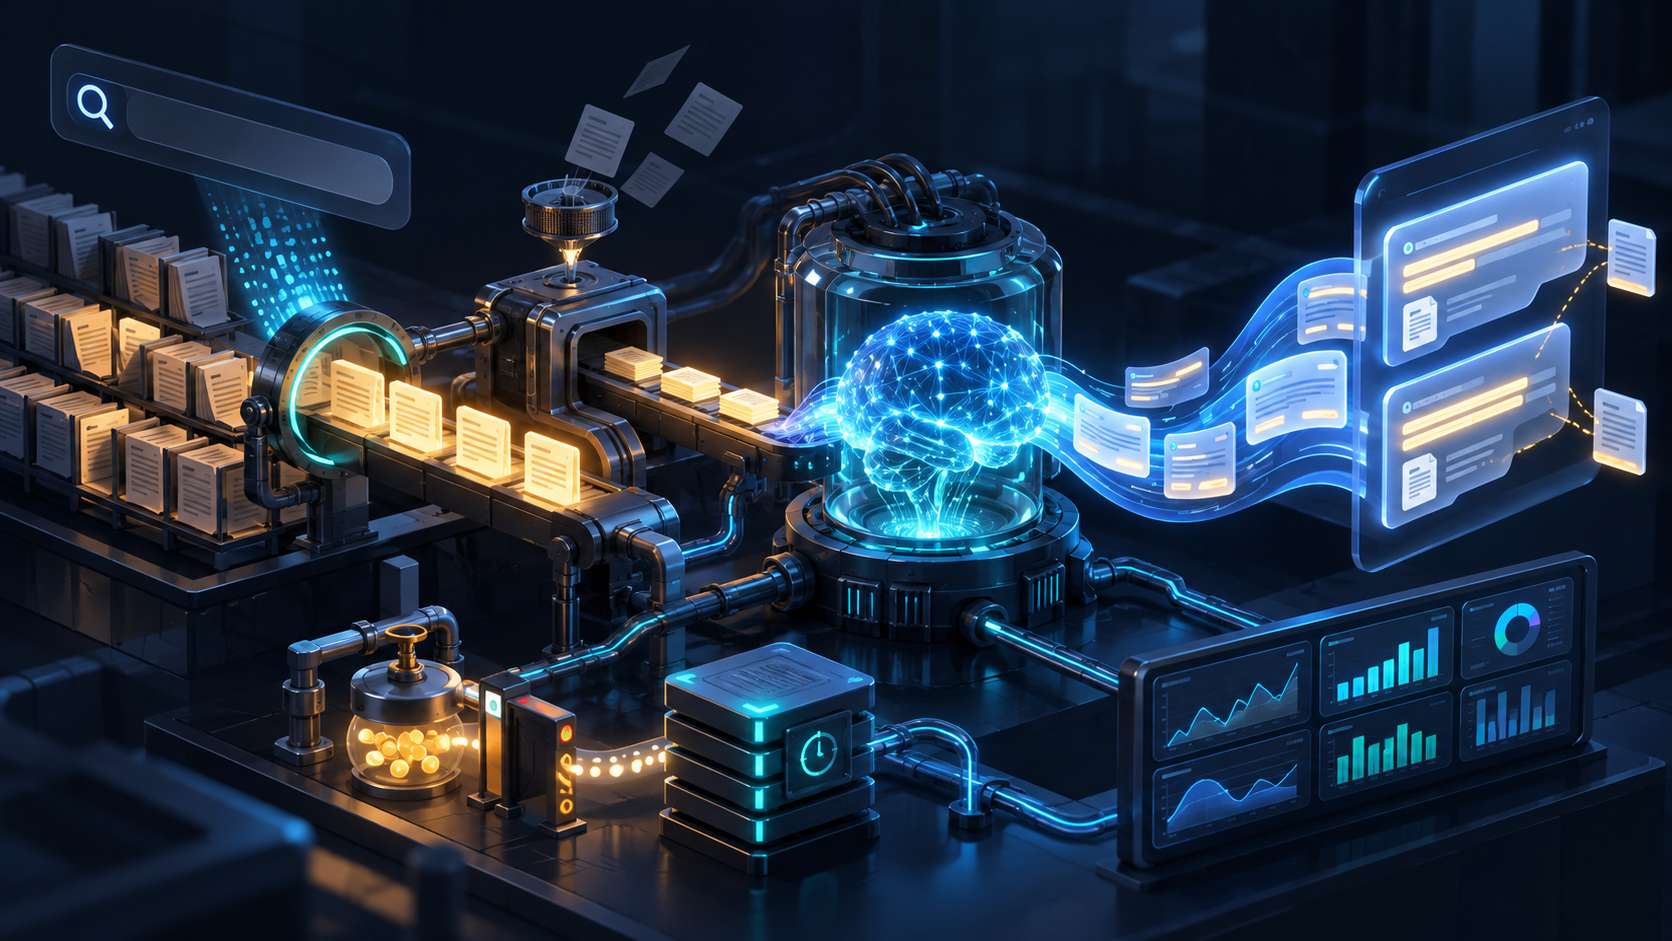
Lucene BM25 검색 결과 Top-5 문서를 LLM 컨텍스트에 주입하는 RAG(Retrieval-Augmented Generation) 파이프라인을 구축한다. Spring AI 2.0 + Gemini 2.0 Flash로 SSE 스트리밍 답변을 생성하고, 인라인 출처 배지를 파싱하여 게시글 링크로 연결한다. 할루시네이션 방지(문서 기반 답변 제한 + 인용 강제), AI 요약 트리거 조건(네비게이션 의도 스킵), Redis Token Bucket rate limiting(10 RPM 전역), 동일 쿼리 캐싱(TTL 30분, LLM 비용 40-60% 절감), Grafana 7패널 대시보드(RPM, 응답시간, 토큰, 피드백, 비용 추정)까지 포함한다. BM25가 이 프로젝트에서 Dense Retrieval보다 적합한 근거와, Hybrid Retrieval 전환 로드맵도 정리한다.
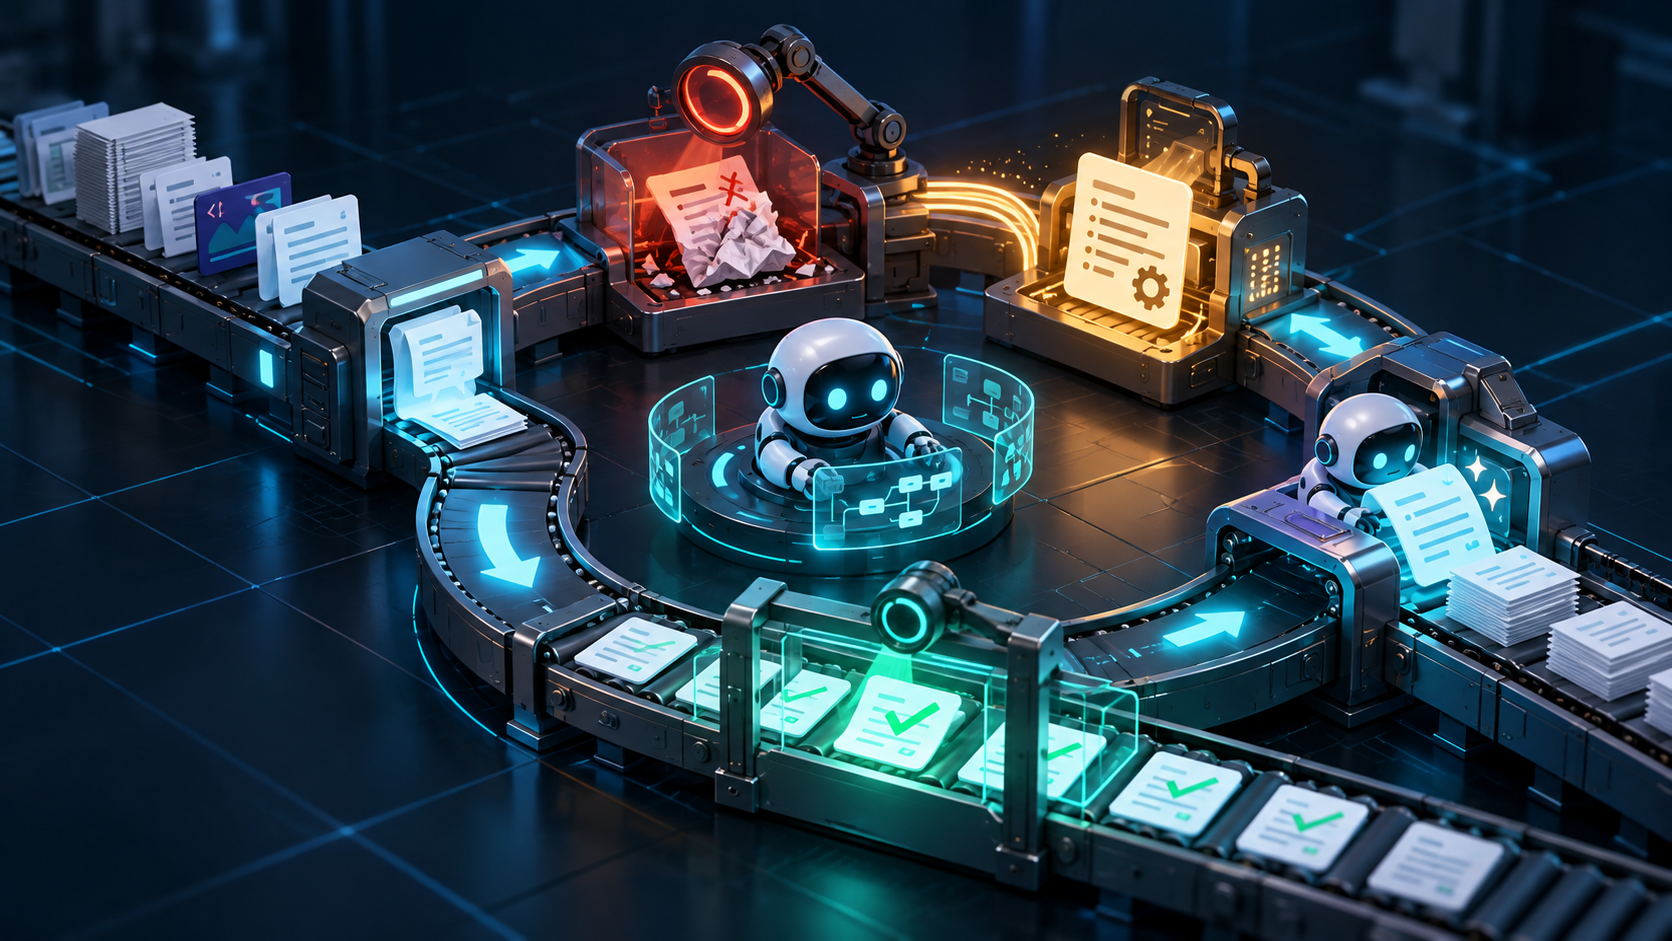
LLM 워크플로우를 실행하고, 실패를 분석하고, 규칙을 자동 생성하고, 회귀 테스트까지 하나의 루프로 연결하는 평가 엔진.
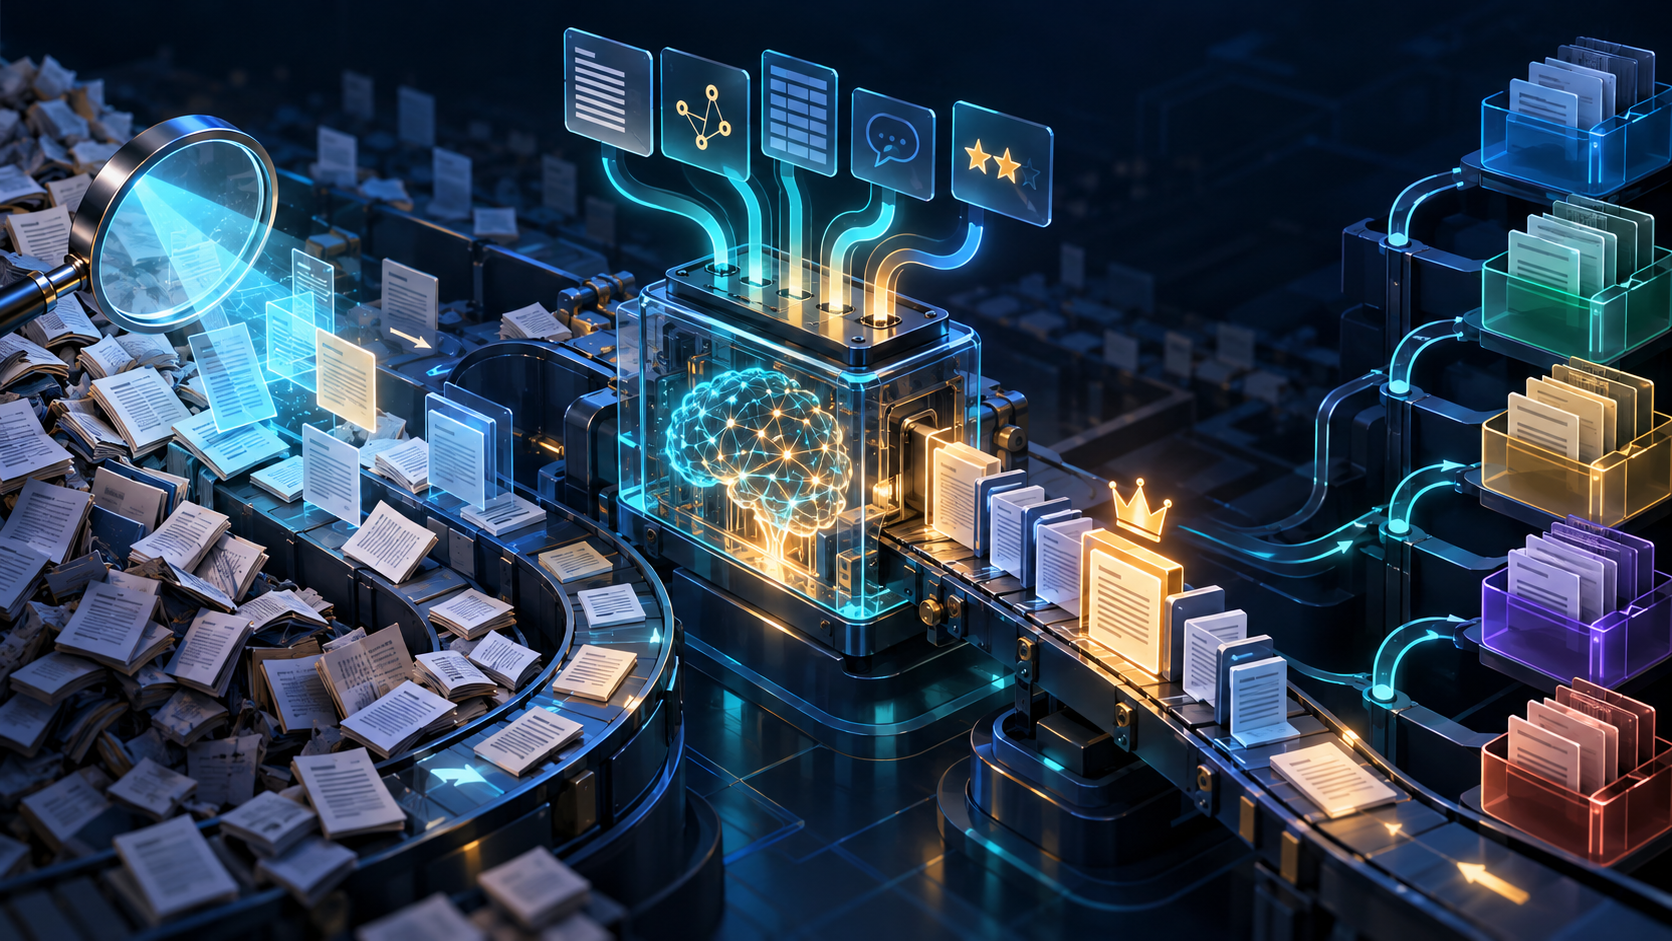
BM25 수동 가중치(title:3, content:1)의 한계를 Learning to Rank(LTR)로 극복한다. 카테고리 28개 자동 분류(키워드 기반, 정확도 83%) → SortedSetDocValuesFacetCounts 네이티브 Facet 전환 → 태그 216만 건 인덱싱을 1회 재색인으로 통합 반영한다. LLM-as-a-Judge(Gemini)로 학습 데이터 900쌍을 생성하고(1차 실패 98% → 5초 딜레이+지수 백오프로 해결), XGBoost LambdaMART 14개 피처로 학습하여 NDCG@10을 0.6910 → 0.7387(+4.8%p) 개선한다. XGBoost4J ARM64 네이티브 추론, Rescorer Top-200 재랭킹, RefreshListener 기반 FacetState 캐싱, MultiCollectorManager 단일 패스 수집까지 구현하지만, 2코어 ARM Free Tier에서 LTR ON 시 CPU 포화(72배 악화)를 k6로 실측하여 LTR_ENABLED=false로 비활성화한다.