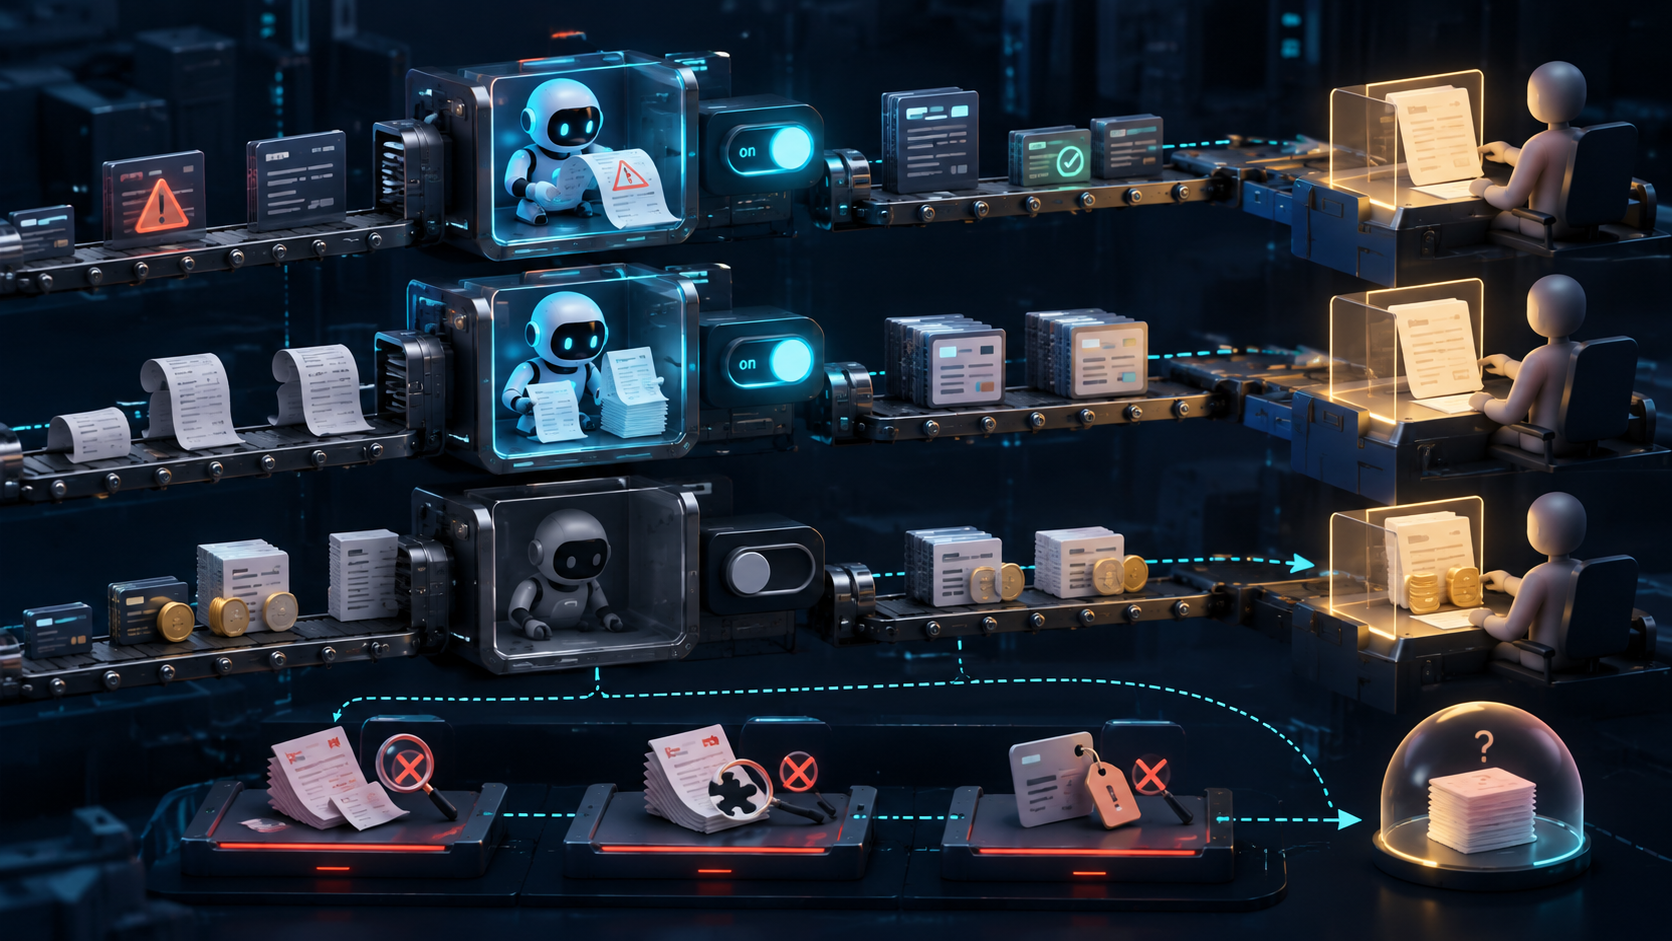
AI를 켤 곳과 끌 곳을 가르는 기준
결제 운영 자동화 세 곳에서 모델을 켜고 끈 기준. 장애 로그 진단과 운영자용 요약은 켰고 대사 원인 분류는 껐다. 그 과정에서 평가 장치도 세 번 틀렸고, 마지막 한 건은 모델이 아니라 제 라벨이 틀렸을 가능성으로 남겼다.
검색 결과가 없습니다
제목, 태그, 카테고리로 검색
결제 운영 자동화 세 곳에서 모델을 켜고 끈 기준. 장애 로그 진단과 운영자용 요약은 켰고 대사 원인 분류는 껐다. 그 과정에서 평가 장치도 세 번 틀렸고, 마지막 한 건은 모델이 아니라 제 라벨이 틀렸을 가능성으로 남겼다.
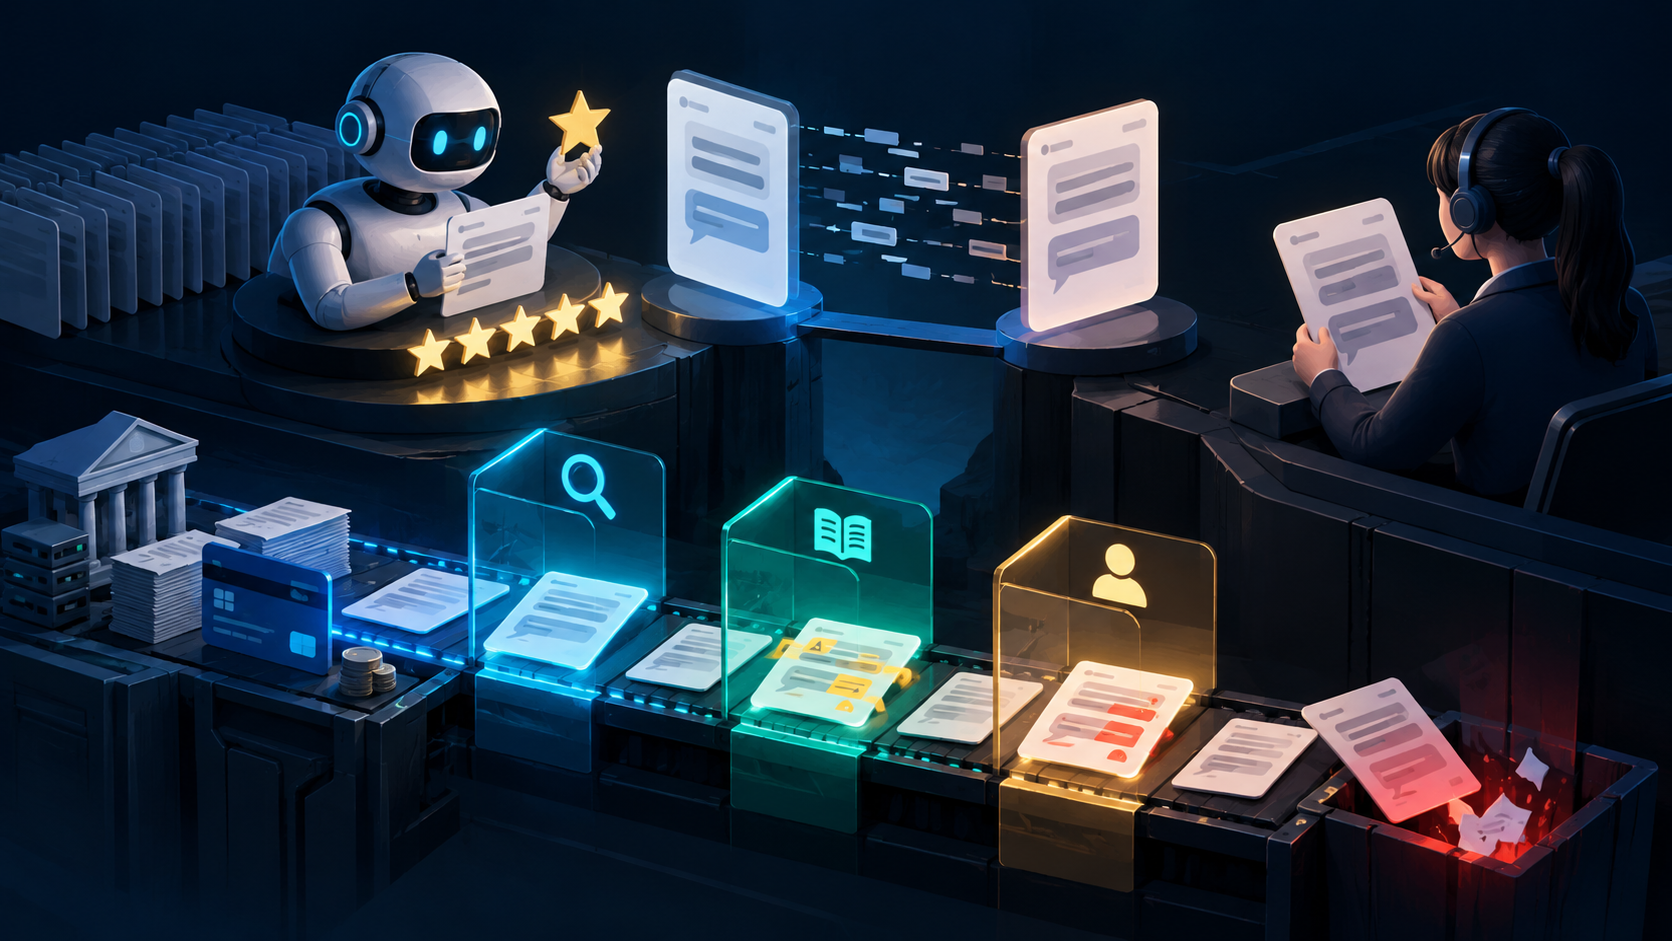
결제 상담 초안을 자동 채점하는 루브릭이 평균 4.97/5점을 줬지만, 사람이 블라인드로 쓴 답과 비교하니 편집 거리 중앙값이 45.6%였다. 루브릭을 조이면 정상 문장을 놓치고, 고객 영향을 요구하면 모델이 모르는 것까지 단언했고, 다른 계열 심판도 틀렸다.