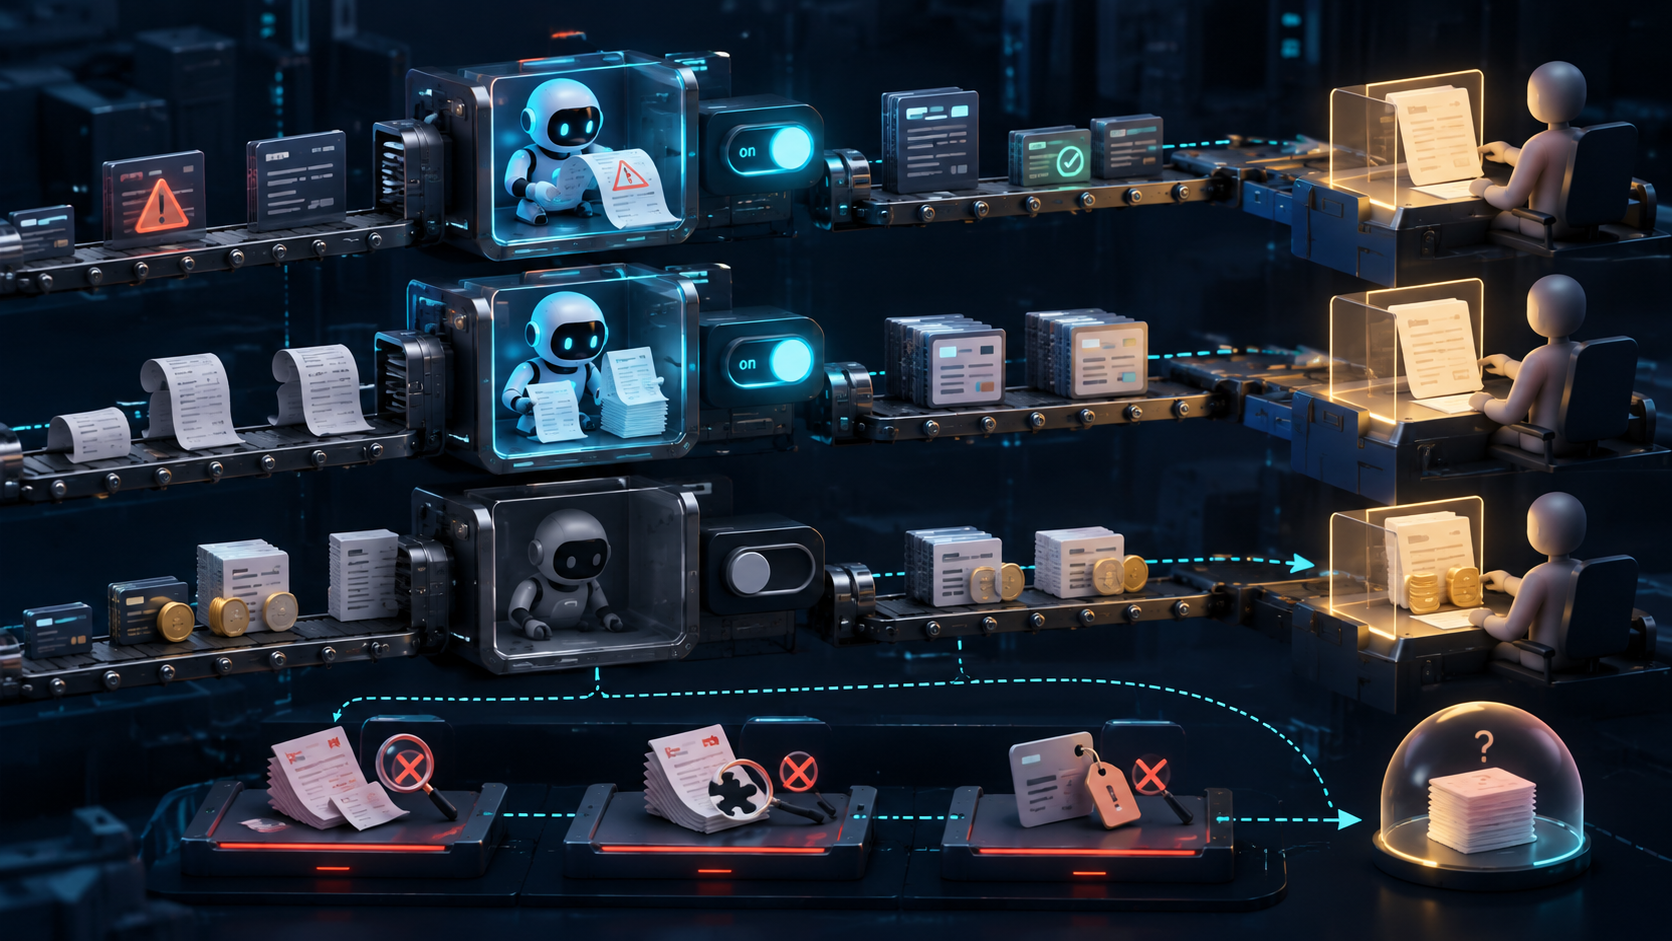
AI를 켤 곳과 끌 곳을 가르는 기준
결제 운영 자동화 세 곳에서 모델을 켜고 끈 기준. 장애 로그 진단과 운영자용 요약은 켰고 대사 원인 분류는 껐다. 그 과정에서 평가 장치도 세 번 틀렸고, 마지막 한 건은 모델이 아니라 제 라벨이 틀렸을 가능성으로 남겼다.
검색 결과가 없습니다
제목, 태그, 카테고리로 검색
결제 운영 자동화 세 곳에서 모델을 켜고 끈 기준. 장애 로그 진단과 운영자용 요약은 켰고 대사 원인 분류는 껐다. 그 과정에서 평가 장치도 세 번 틀렸고, 마지막 한 건은 모델이 아니라 제 라벨이 틀렸을 가능성으로 남겼다.
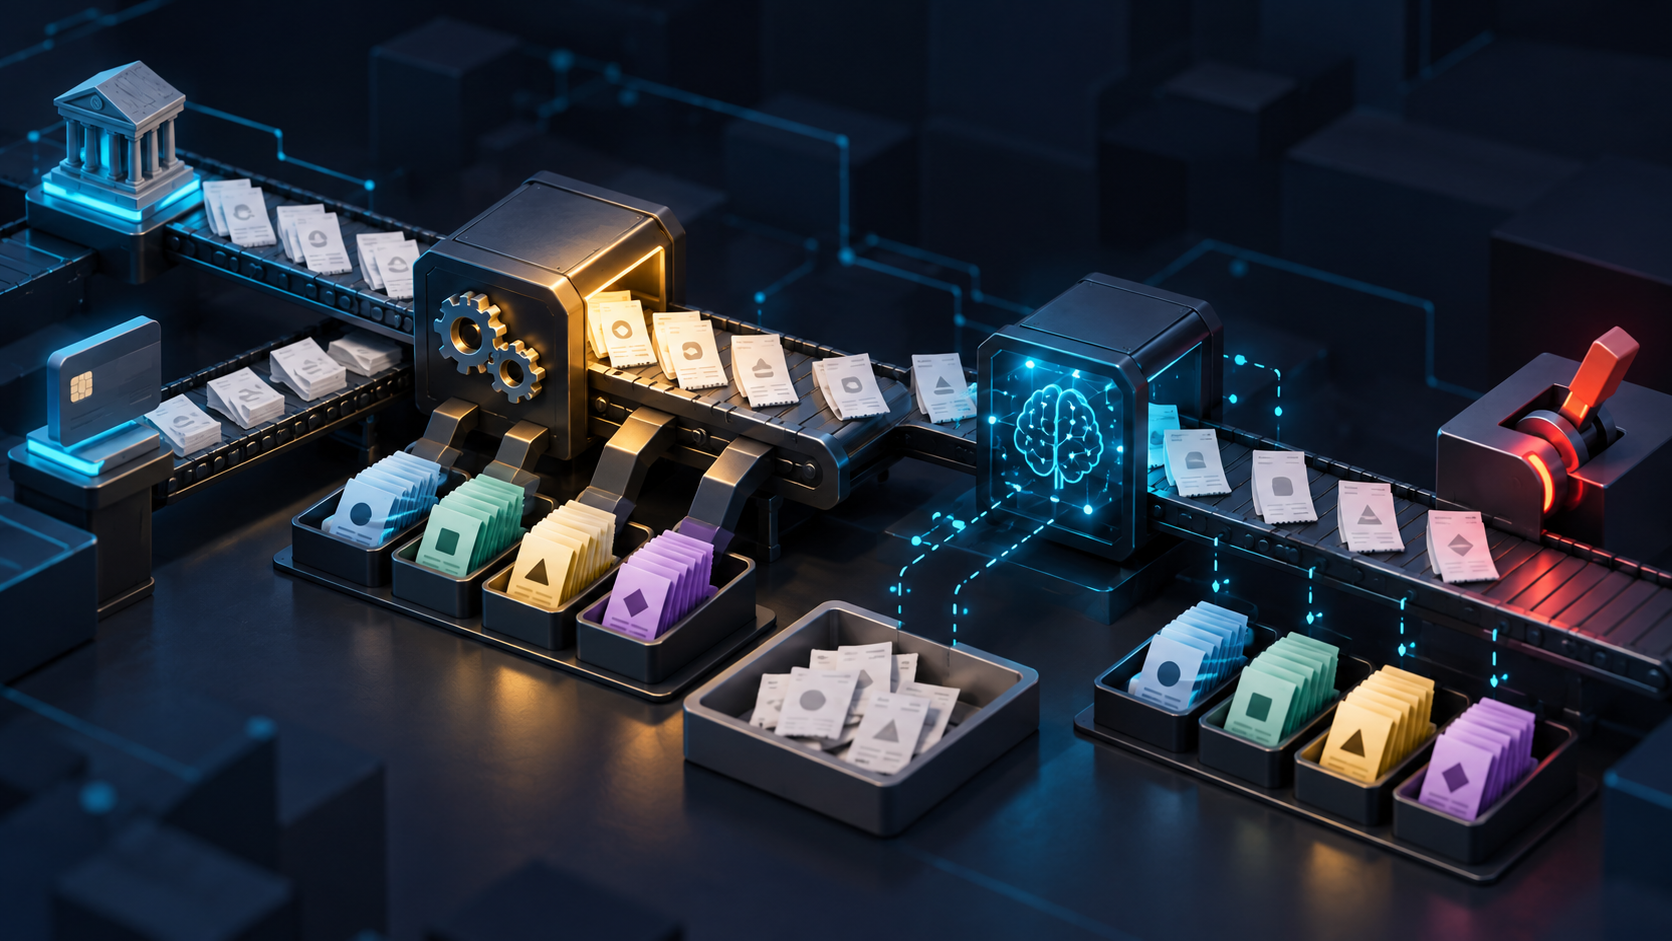
규칙이 설명하지 못한 대사 예외에 모델을 붙였지만, 실제 잔여 분포에서 규칙 분류기와 같은 답을 냈다. 개발 표본의 91~100%만 보고 자동화를 켜지 않고, 홀드아웃에서 개선이 0임을 확인한 뒤 기본값을 규칙으로 유지한 이유를 정리한다.
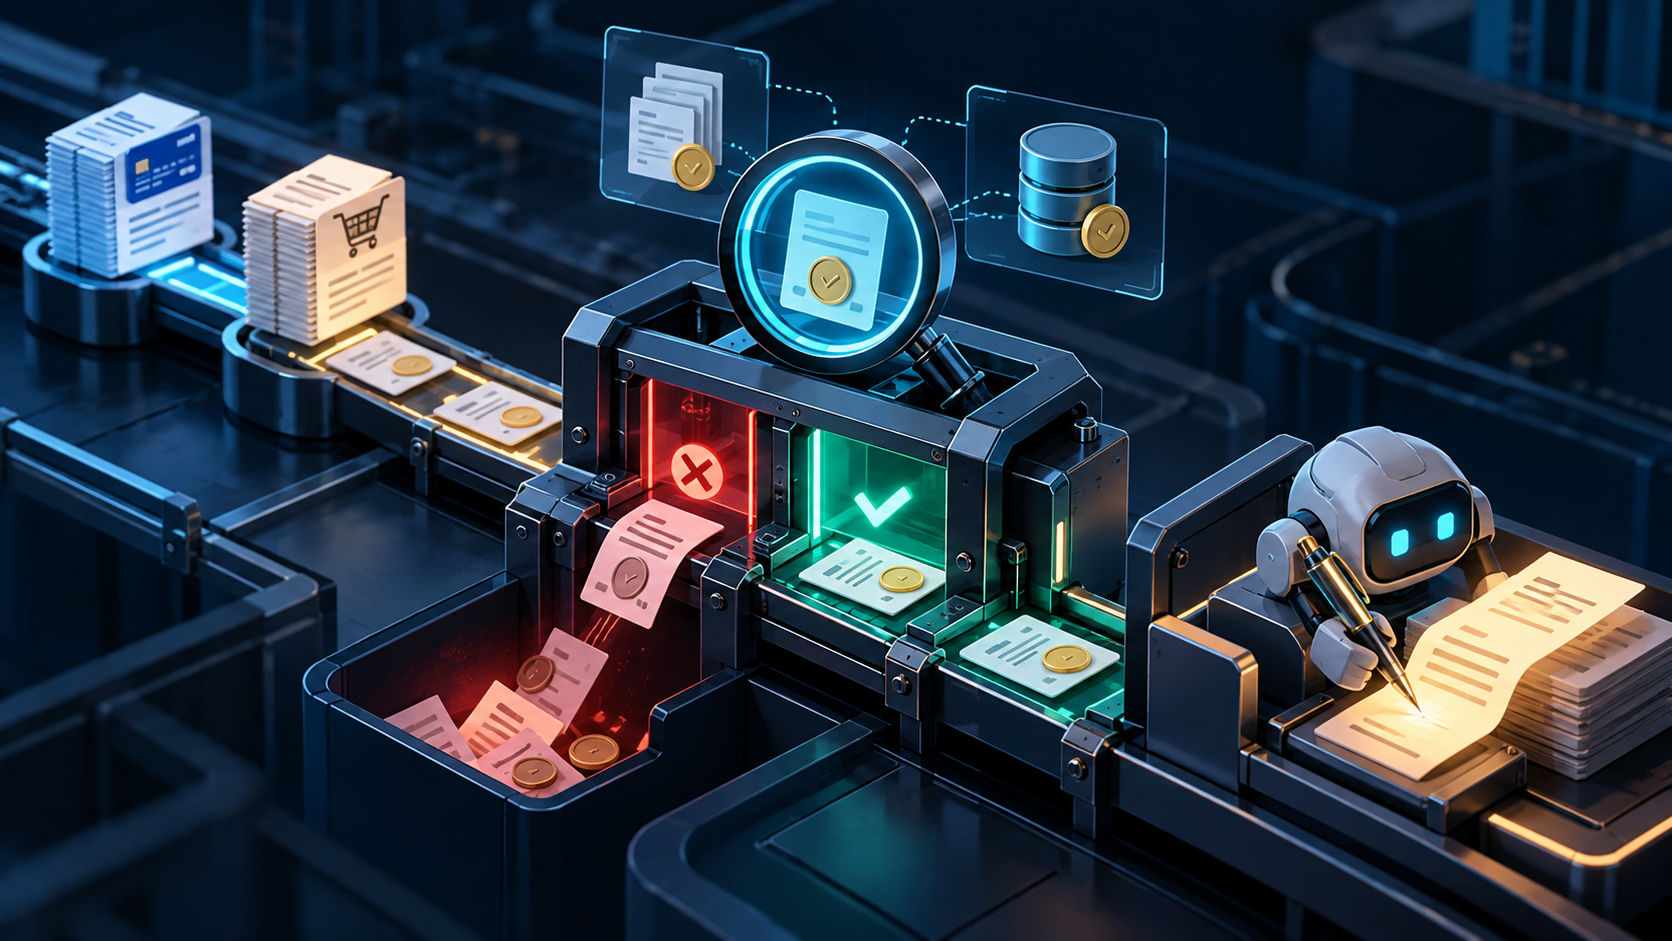
모델을 붙이기 전에 포트와 숫자 검증기부터 만들었다. 실제 데이터를 넣자 검증기가 분류기가 계산한 진짜 270원을 출처에 없다며 반려했고, 고친 뒤에도 반복 실행에서만 드러나는 결함이 둘 더 나왔다.
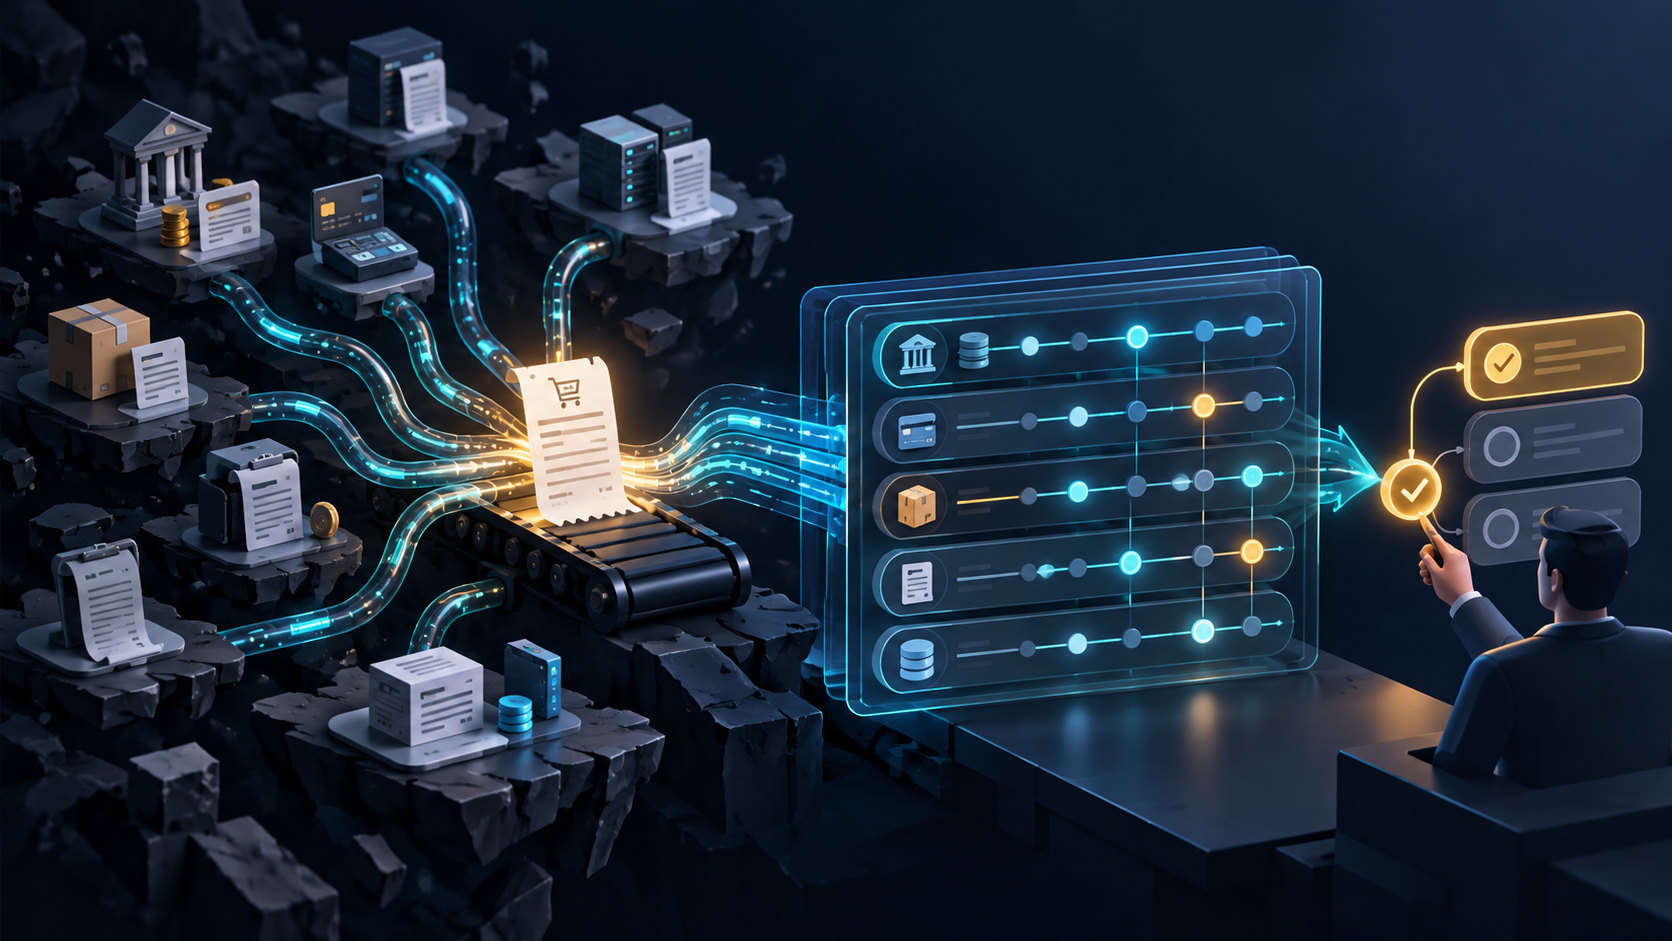
결제 대사 담당자가 한 주문의 원인을 판단하려면 API 7회와 목록 검색 6회를 거쳐야 했다. 여러 도메인의 근거를 읽기 전용 타임라인으로 모으고, 확정 가능한 원인만 근거와 함께 제안하도록 바꾼 과정을 정리한다.
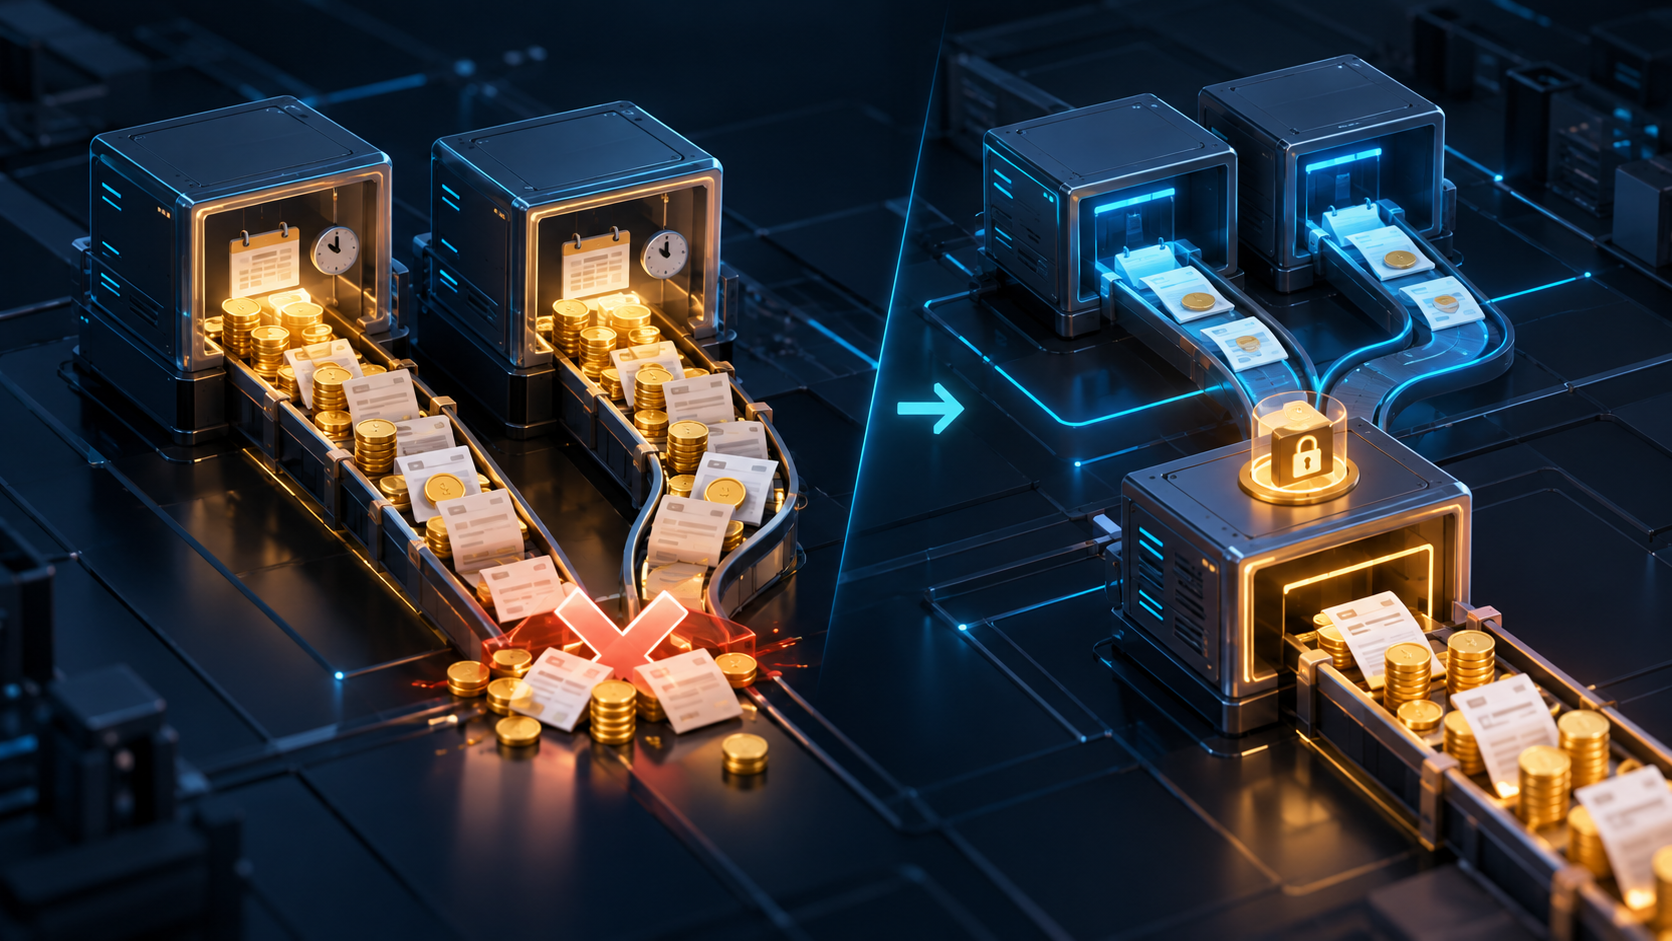
API 인스턴스를 둘로 늘리자 같은 정산 배치가 중복 실행됐고, 한 대로 유지하자 배포 중 결제 요청이 실패했다. 유니크 제약만으로는 실행권을 정할 수 없어서, MSA 분리 대신 API와 워커의 실행·배포 단위를 나눈 과정을 정리한다.