모든 태그

# Debezium

4개의 글

[DE Ch-20] CDC로 레이크하우스 채우기: 조회는 상태를 보고 로그는 변경을 본다

원천 DB의 변경을 레이크하우스로 옮기는 방법은 updated_at을 주기적으로 조회하는 방식과 DB의 변경 로그를 읽는 방식으로 나뉩니다. 조회 방식은 삭제와 중간 상태를 놓친다는 것을 SQLite로 재현하고 Debezium이 binlog와 WAL을 읽는 구조, 초기 스냅샷, at-least-once 보장, PostgreSQL replication slot이 디스크를 채우는 경로, Iceberg에 upsert로 반영할 때의 조건을 공식 문서와 사례로 정리합니다.
CDC가 139배 느리게 나왔다: 느렸던 것은 적지 않은 기본값이었다

사용자 활동 로그를 Debezium CDC로 나르게 바꾸고 재 보니 lag p95가 아웃박스의 139배(1,944ms 대 14ms)였다. 그대로 적었으면 CDC를 기각했을 것이다. 커넥터의 지연 설정 셋을 명시하자 13ms로 같아졌다. 그 전에 반영률 0%·오류 로그 0건인 측정이 있었고 원인은 컨슈머 빈이 아예 없던 것이었다.

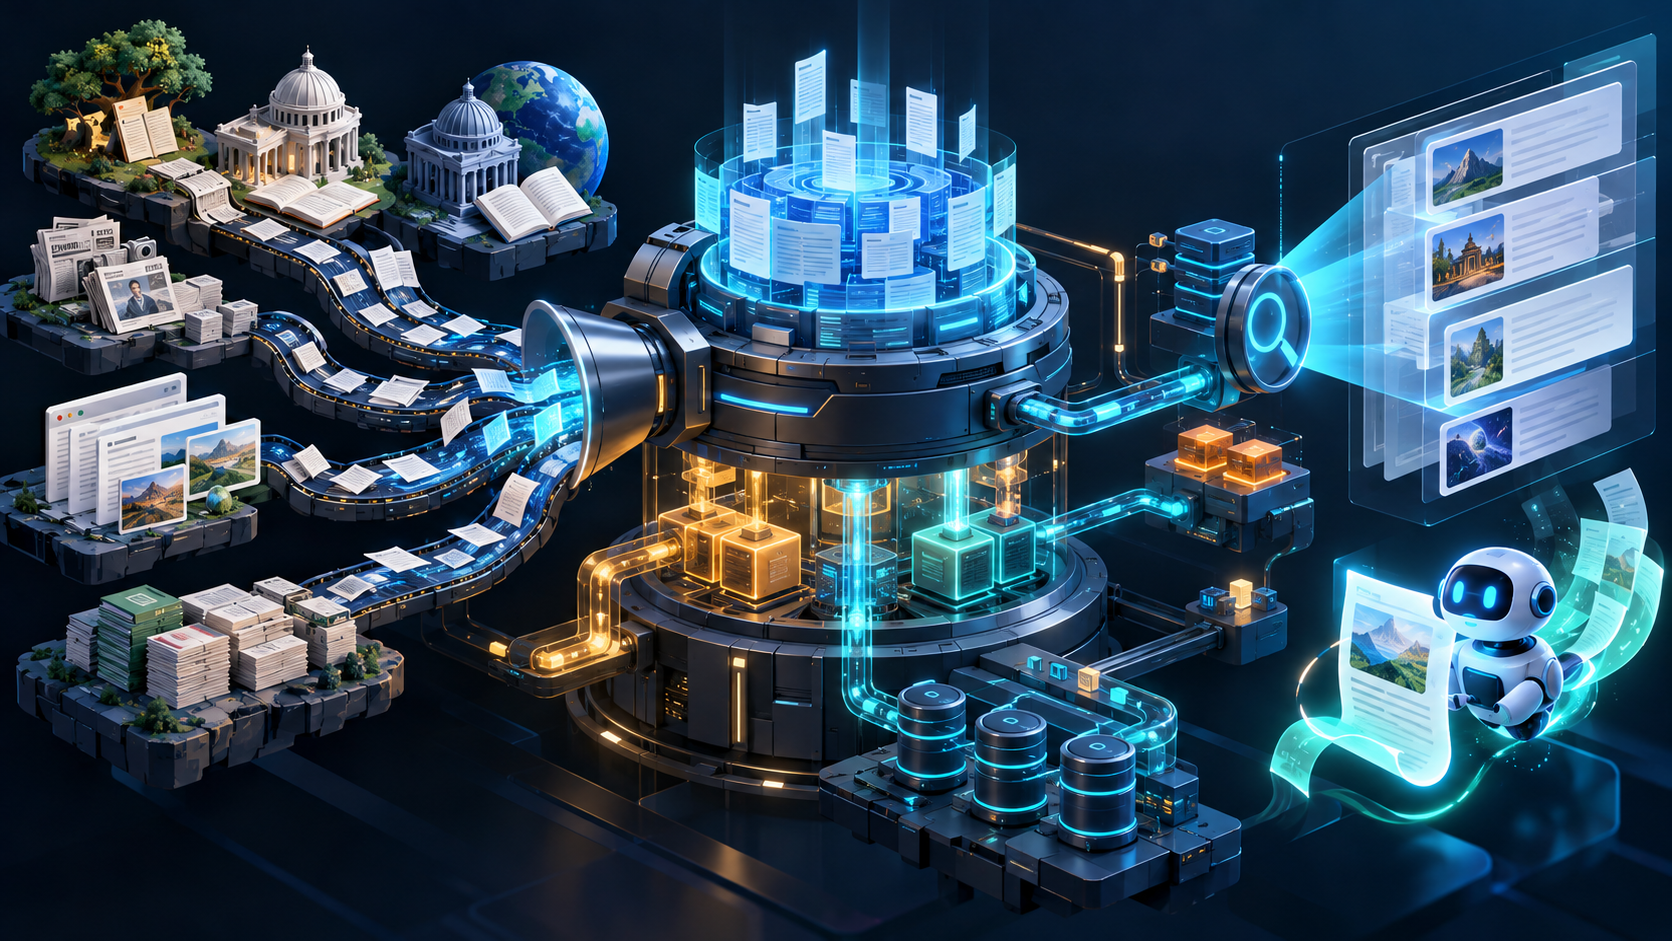
WikiEngine 총정리: 1,215만 건 검색 엔진의 설계부터 RAG까지

나무위키+한국어 위키백과+영어 위키백과+뉴스+웹텍스트+C4 한국어 코퍼스 1,215만 건 검색 엔진 프로젝트를 2개월간 26편의 기술 블로그로 기록하고 총정리한다. MySQL LIKE 5,000ms 타임아웃에서 시작하여 임베디드 Lucene + Nori 한국어 형태소 분석으로 전환하고, Caffeine+Redis 2계층 캐시(82% 히트율), MySQL Replication R/W 분리, Nginx 스케일아웃(에러율 13.25%→0%), Debezium+Kafka CDC, Redis 3노드 Consistent Hashing까지 분산 아키텍처를 완성한다. 검색 품질은 동의어 확장, 오타 교정, UnifiedHighlighter snippet, LTR(NDCG +4.8%p), 카테고리 28개 자동 분류, Aho-Corasick 금칙어 필터링으로 고도화하고, RAG(Gemini SSE 스트리밍)로 AI 검색 요약을 제공한다. 자동완성 시스템 설계(CQRS + MapReduce + CDC)의 이론과 실제 구현의 매핑, 26편 전체 시리즈 링크, 핵심 수치 총정리를 포함한다.

CDC (Change Data Capture): 이벤트 기반 동기화

PostService의 dual-write 구조(MySQL + Lucene 직접 호출)가 데이터 불일치, 강결합, 불완전한 캐시 무효화를 유발하는 문제를 점진적으로 해결한다. Spring ApplicationEvent로 디커플링 → @ApplicationModuleListener 비동기 전환(쓰기 5,315ms→33ms) → Debezium + Kafka CDC로 binlog 기반 모든 변경 캡처까지. 100 VU 부하 테스트로 각 전환을 검증하고, dual-write를 원천 차단하여 검색 인덱스 정확성을 보장한다.