[DE Ch-01] 데이터 파이프라인의 큰 그림: 입력이 끝나는지, 원본을 남기는지
데이터가 생겨서 쓰이기까지 다섯 단계를 거칩니다. 배치와 스트림은 속도보다 입력이 끝나는지로 갈리고 Lambda와 Kappa는 같은 계산을 몇 벌 유지하는지로 갈립니다. 메달리온 구조가 원본을 고치지 않고 남기는 이유를 DuckDB로 버그를 냈다가 되살리며 확인합니다.
검색 결과가 없습니다
제목, 태그, 카테고리로 검색
데이터가 생겨서 쓰이기까지 다섯 단계를 거칩니다. 배치와 스트림은 속도보다 입력이 끝나는지로 갈리고 Lambda와 Kappa는 같은 계산을 몇 벌 유지하는지로 갈립니다. 메달리온 구조가 원본을 고치지 않고 남기는 이유를 DuckDB로 버그를 냈다가 되살리며 확인합니다.
배치 작업에는 시계가 둘 있습니다. 언제 실행하는지와 어느 구간의 데이터를 처리하는지입니다. Airflow 2는 둘을 data interval로 묶었고 Airflow 3는 기본 timetable을 바꿔 매일 00시 run의 ds가 어제에서 오늘이 됐습니다. 이 차이를 DuckDB로 재현하고 catchup과 backfill이 지난 구간을 다시 돌리는 방식, Argo CronWorkflow가 같은 문제를 다루는 방식을 정리합니다.
at-most-once와 at-least-once는 컨슈머가 처리와 커밋 중 무엇을 먼저 하느냐로 갈립니다. Kafka의 exactly-once는 처리 결과와 읽은 위치를 한 트랜잭션으로 커밋해서 만듭니다. 컨슈머가 처리 도중 죽는 상황을 세 방식으로 재현하고 KIP-98의 트랜잭션 구조와 비용, read_committed 독자가 기다리는 시간, 외부 DB로 나갈 때 보장이 끝나는 지점을 공식 문서와 사례로 정리합니다.
메시지를 쓰는 쪽과 읽는 쪽은 서로 다른 시점에 배포됩니다. 스키마 레지스트리의 호환성 모드는 새 스키마로 옛 데이터를 읽을 수 있는지(BACKWARD), 옛 스키마로 새 데이터를 읽을 수 있는지(FORWARD)를 등록 시점에 검사합니다. 필드 추가, 삭제, 타입 변경이 각 방향에서 읽히는지를 fastavro로 직접 확인하고 Avro 스키마 해석 규칙, Confluent 레지스트리의 기본값과 업그레이드 순서 Protobuf와 JSON Schema의 차이, data contract까지 정리합니다.
cron으로 스크립트를 시간 차를 두고 돌리면 의존성, 재시도, 실행 기록, 지난 날짜 재실행, 실패 알림이 빠집니다. Airflow 3와 Argo Workflows가 이 일을 어떤 부품으로 나눠 맡는지, 실행 상태를 어디에 두는지, 부품 하나가 죽으면 무엇이 멈추는지 공식 문서와 기술블로그로 정리합니다.
데이터가 언제 도착할지 모르면 cron은 너무 이르거나 너무 늦습니다. 센서로 폴링하면 확인 비용과 발견 지연이 생기고 이벤트로 받으면 중복과 유실을 따로 다뤄야 합니다. Airflow 3의 Asset과 AssetWatcher, Argo Events가 이벤트를 어떻게 합치고 거르는지 공식 문서로 정리하고 폴링 비용을 시뮬레이션으로 셉니다.
MQTT는 연결이 자주 끊기는 기기를 위한 가벼운 메시징 프로토콜입니다. QoS 0, 1, 2는 발행자에서 브로커, 브로커에서 구독자 구간마다 따로 적용되고 구독 쪽이 낮으면 낮은 쪽으로 내려갑니다. QoS 2의 정확히 한 번도 한 구간 안의 이야기입니다. MQTT 5.0 명세로 토픽 와일드카드, QoS 흐름, retained 메시지, 세션을 정리하고 Mosquitto 설정과 MQTT에서 Kafka로 넘길 때의 전달 보장을 봅니다.
Kafka의 토픽은 파티션으로 나뉜 추가 전용 로그입니다. 순서는 파티션 안에서만 보장되고 같은 키는 murmur2 해시로 같은 파티션에 갑니다. 파티션 수를 6개에서 8개로 늘리면 키의 74.6%가 다른 파티션으로 옮겨 간다는 것을 Kafka와 같은 해시로 확인합니다. 세그먼트와 보존, 오프셋 저장, 컨슈머 그룹과 리밸런스 프로토콜의 변화, 복제와 ISR까지 Kafka 4.3 문서 기준으로 정리합니다.
Kafka 프로듀서는 레코드를 배치로 모아 보냅니다. linger.ms만큼 더 기다리면 배치가 커지고 요청 수가 줄어 오히려 지연이 줄기도 합니다. Kafka 4.0에서 linger.ms 기본값이 0에서 5로 바뀐 이유와, acks, 멱등성, max.in.flight가 내구성과 순서를 어떻게 정하는지 공식 문서와 측정 글로 정리하고 메시지 유입량에 따라 linger가 의미를 갖는 구간을 단순 모델로 셉니다.
끝이 없는 입력에서는 "이 구간의 데이터가 다 왔다"를 알 수 없어서 watermark라는 추정을 씁니다. watermark를 늦게 잡으면 결과가 늦고 빨리 잡으면 늦게 온 데이터를 버립니다. 허용치별로 버려지는 이벤트와 결과 지연을 시뮬레이션으로 세고 조용한 파티션 하나가 전체 watermark를 붙잡는 현상과 idleness 설정을 Flink 2.3 문서와 사례로 정리합니다.
끝이 없는 스트림을 집계하려면 시간으로 잘라야 하고 두 스트림을 이으려면 시간 범위 안에서 짝을 찾아야 합니다. Flink의 텀블링, 슬라이딩, 세션, 글로벌 윈도와 trigger, evictor가 결과를 내는 시점을 정리하고 주문과 결제를 interval join으로 이을 때 범위를 넓힐수록 짝지어지는 비율과 붙들고 있어야 하는 상태가 함께 늘어나는 것을 시뮬레이션으로 셉니다.
Flink는 배리어를 데이터 사이에 흘려 전체 상태의 스냅샷을 찍고 장애가 나면 마지막 스냅샷부터 다시 처리합니다. exactly-once 싱크는 체크포인트가 끝날 때 결과를 커밋하므로 간격이 곧 결과가 보이기까지의 지연이 됩니다. 간격별 가시성 지연과 장애 때 재처리량을 시뮬레이션으로 세고 백프레셔가 배리어를 늦춰 체크포인트가 길어지는 경로와 unaligned 체크포인트, buffer debloating, buffer timeout을 Flink 2.3 문서로 정리합니다.
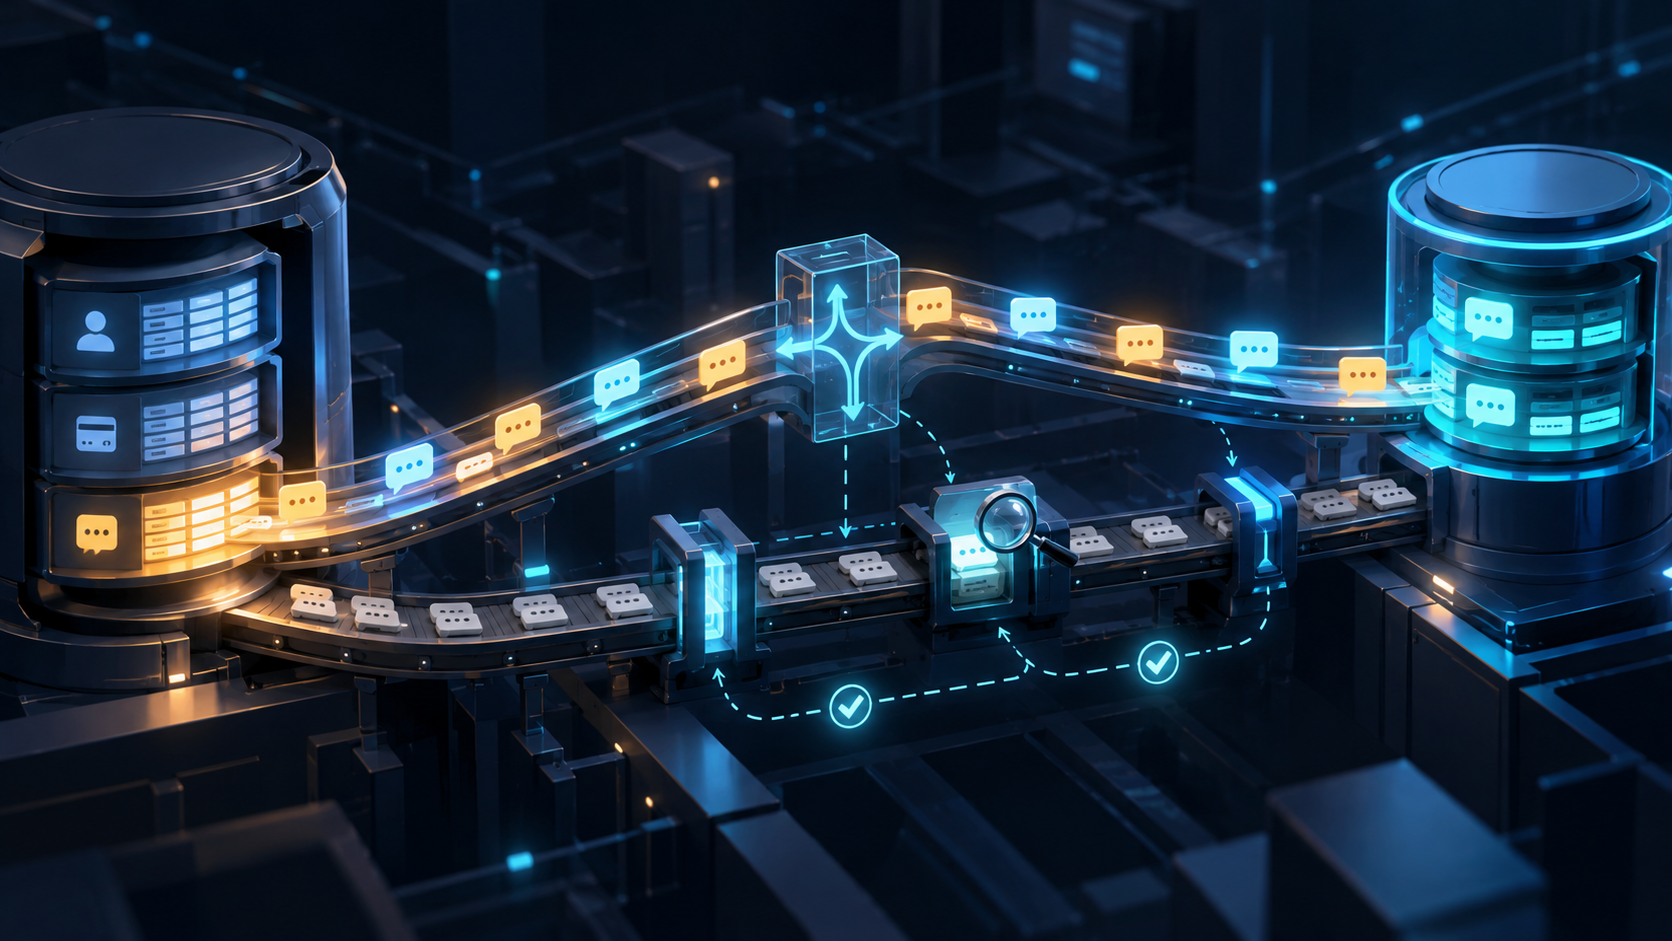
빌려조잉의 채팅 메시지 테이블을 전용 DB로 옮기는 과정을 구간마다 쟀습니다. 310만 행은 이중 쓰기, 백필, 검증으로 333초에 옮겼고 그동안 전달 유실과 순서 뒤집힘은 0이었습니다. 백필 상한은 초당 1만 행으로 정했습니다. 읽기 전환과 정본 교대는 약 14만 행 데이터에서 쟀고 교대와 되돌림에서 쓰기를 막은 시간은 473ms와 352ms였습니다. 전부 로컬 한 대에서 잰 값입니다.
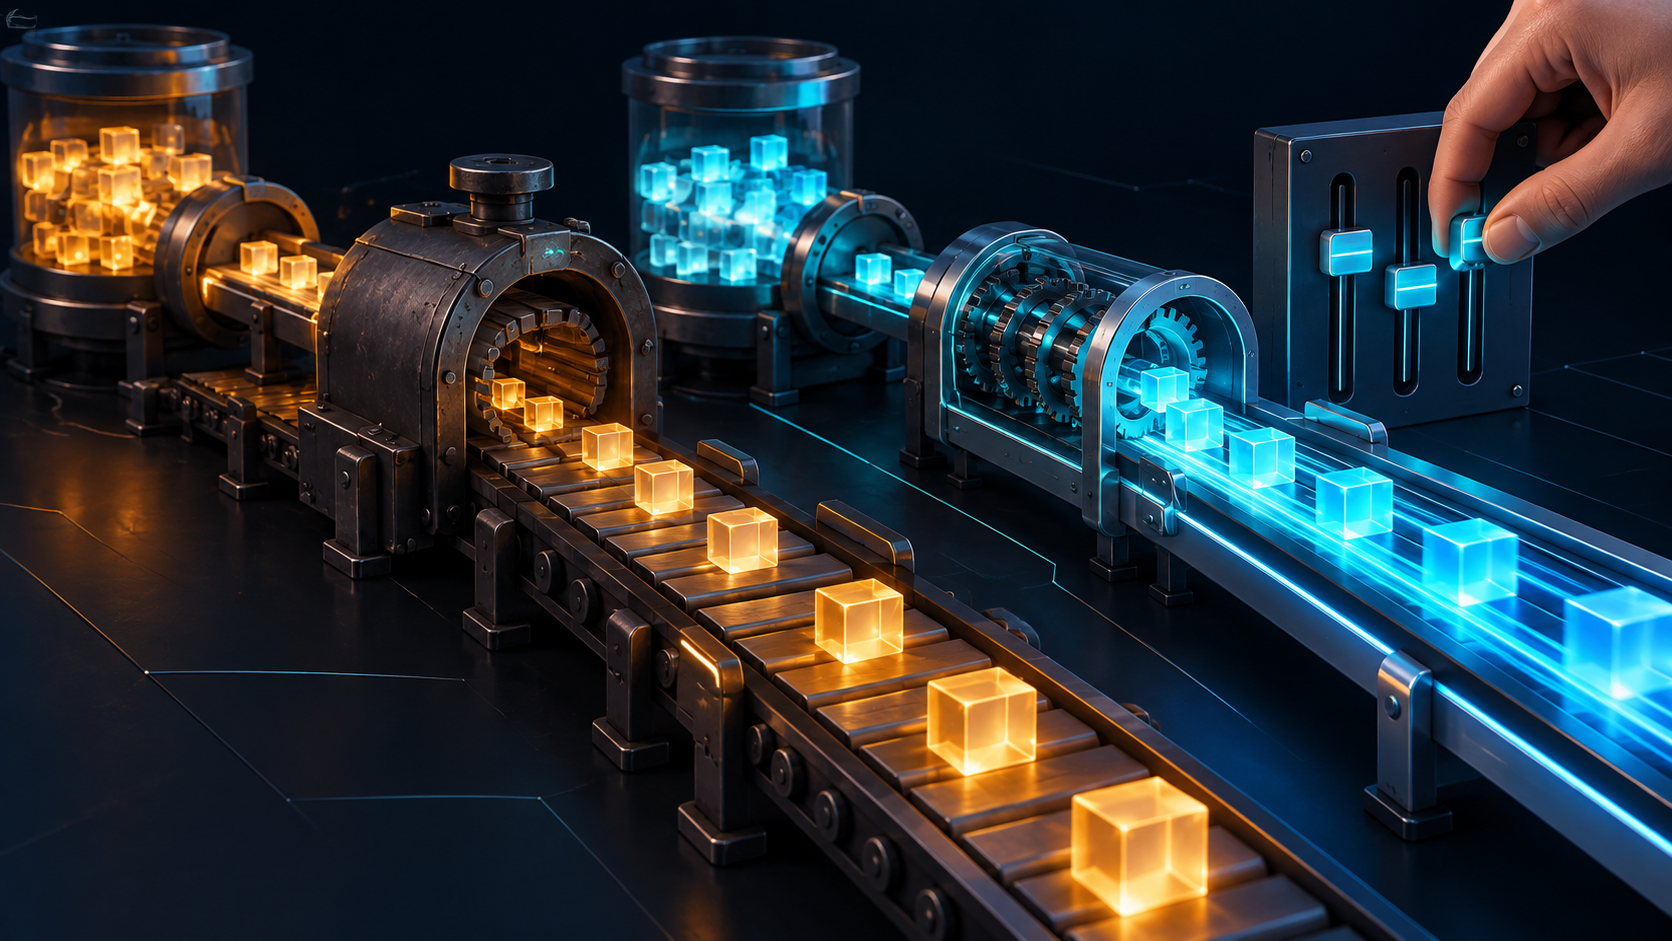
사용자 활동 로그를 Debezium CDC로 나르게 바꾸고 재 보니 lag p95가 아웃박스의 139배(1,944ms 대 14ms)였다. 그대로 적었으면 CDC를 기각했을 것이다. 커넥터의 지연 설정 셋을 명시하자 13ms로 같아졌다. 그 전에 반영률 0%·오류 로그 0건인 측정이 있었고 원인은 컨슈머 빈이 아예 없던 것이었다.
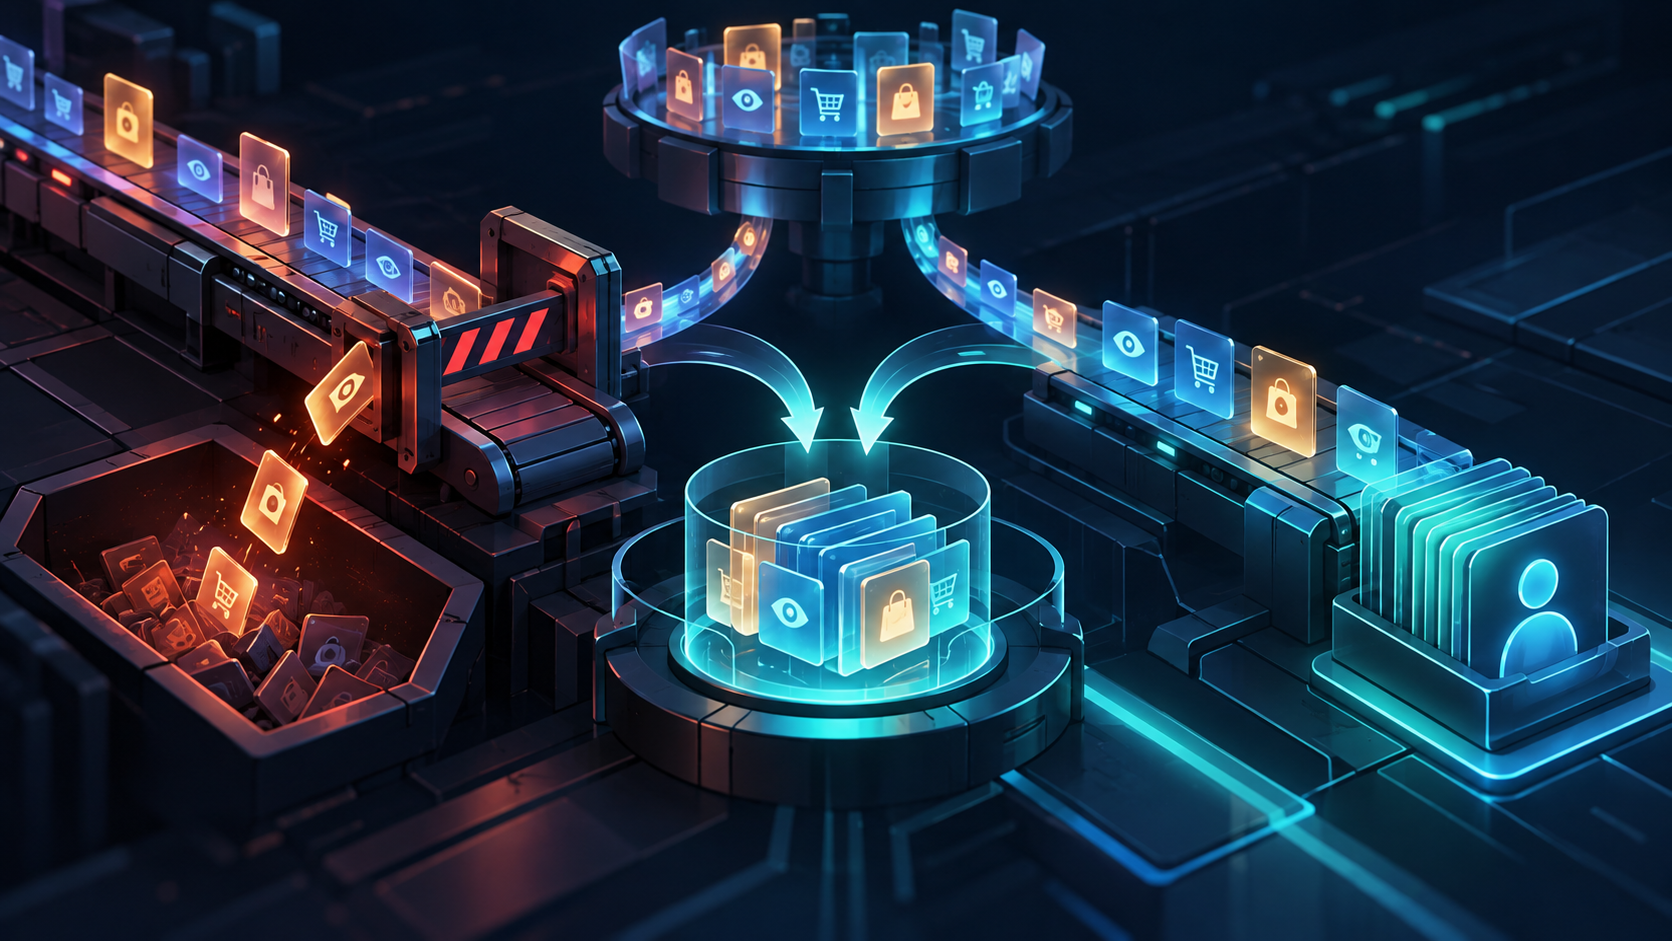
같은 활동 로그로 만든 온라인 컨텍스트와 오프라인 재계산이 순서가 뒤집힌 조건에서 20명 전원 갈라졌다(일치율 0%). 병합 규칙이 늦게 온 이벤트를 버리고 있었다. 사용자별 순서 보장을 사는 대신 병합을 순서에 무관하게 바꿔 100%로 맞췄다. 목록 길이로 세던 창 집계는 60%만 맞았고 재는 도구도 같은 잘림을 물려받고 있었다.
자체 목 PG가 승인 응답 뒤에만 웹훅을 보내도록 만들어 선행 웹훅 경로를 놓쳤다. 결제 행이 아직 없을 때 예외를 던지면 보류 상태까지 롤백되는 문제를 재현하고, 먼저 온 웹훅을 보류 후 재처리하는 구조로 바꾼 과정을 정리한다.
미니 RDBMS(db-hobby)를 만들며 남긴 WAL을 보다가 생각이 하나로 모였다. 이 로그를 주인공으로 승격시켜 여러 노드에 복제하면 그게 Kafka다. Java로 바닥부터 만드는 토이 Kafka 연재의 1편. 코드를 쓰기 전에 끝낸 설계 결정들(분산 로그가 뭔지, 왜 Java인지, 단일 브로커 먼저 왜 그런지)과, 이번엔 단위 테스트 대신 "상황 시뮬레이션"으로 검증하기로 한 이유를 정리한다.
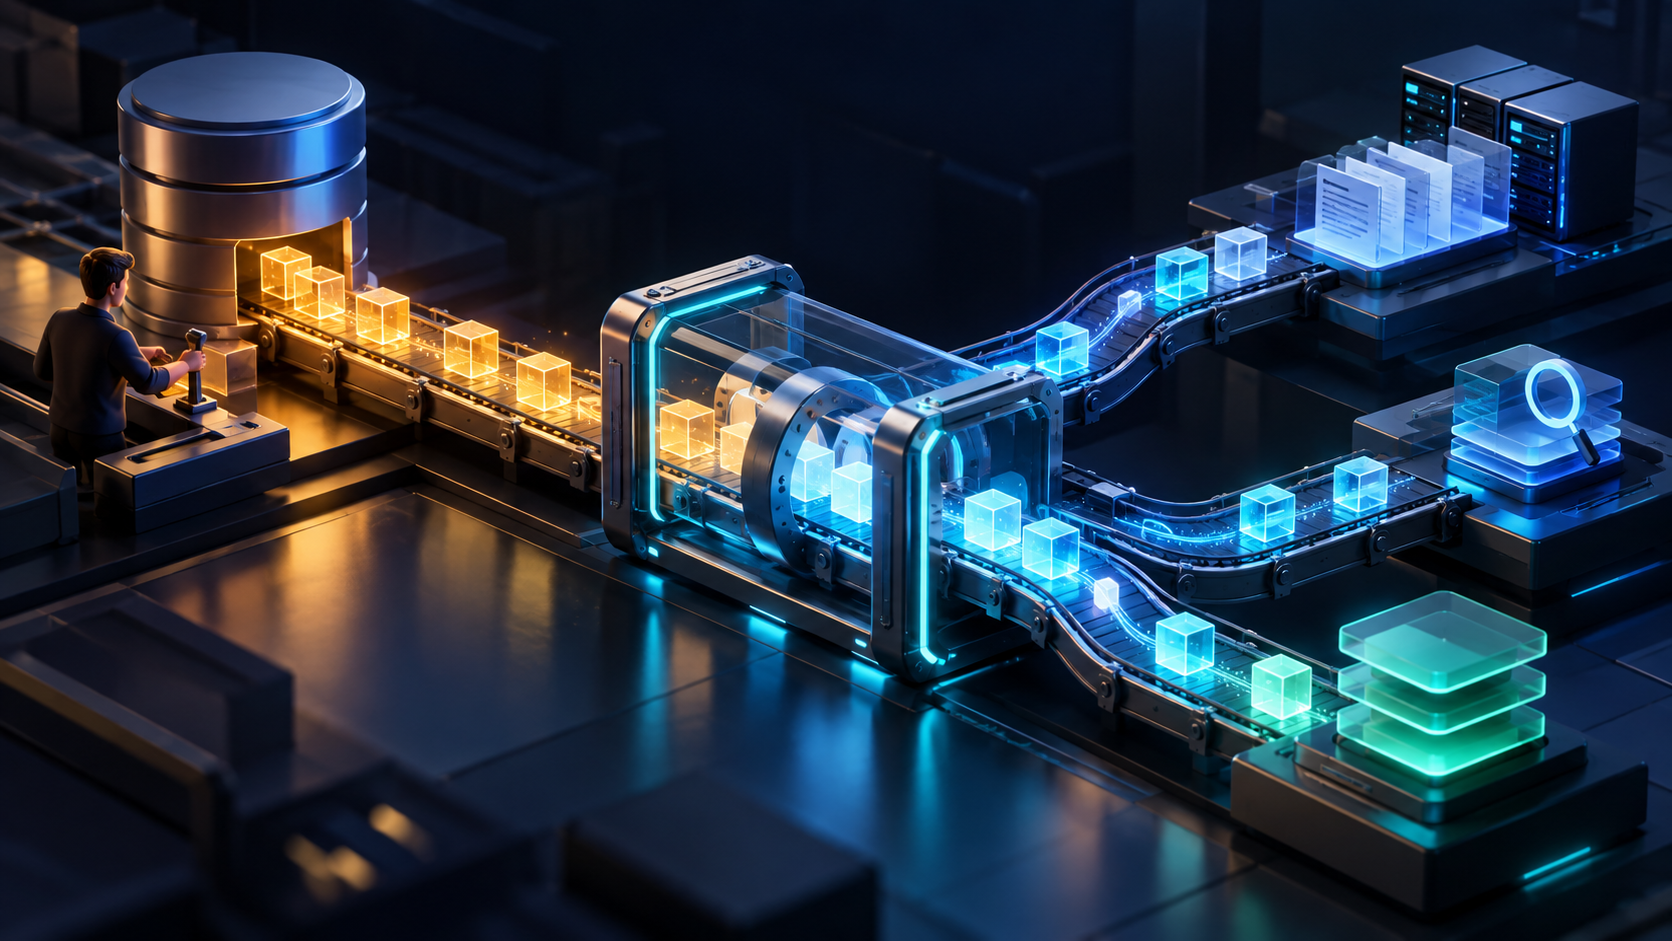
PostService의 dual-write 구조(MySQL + Lucene 직접 호출)가 데이터 불일치, 강결합, 불완전한 캐시 무효화를 유발하는 문제를 점진적으로 해결한다. Spring ApplicationEvent로 디커플링 → @ApplicationModuleListener 비동기 전환(쓰기 5,315ms→33ms) → Debezium + Kafka CDC로 binlog 기반 모든 변경 캡처까지. 100 VU 부하 테스트로 각 전환을 검증하고, dual-write를 원천 차단하여 검색 인덱스 정확성을 보장한다.