채팅이 흐르는 동안 DB를 옮긴다: 이중 쓰기부터 정본 교대까지 실측 기록
목차
빌려조잉의 1:1 채팅을 이어서 다듬는 중입니다. 채팅 메시지 테이블은 회원, 결제와 같은 DB에 있고 대화가 오가는 만큼 계속 쌓입니다. 같은 DB에 두면 다른 도메인과 부하와 VACUUM을 나눠 맞으므로 전용 DB로 분리하기로 했습니다. 조건은 옮기는 동안에도 채팅이 오가야 한다는 것이었습니다. 그래서 채팅을 켜 둔 채로 옮기는 절차를 구간마다 쟀습니다.
먼저 결론입니다.
- 대화가 오가는 동안 메시지 310만 행을 333초에 전용 DB로 옮겼습니다. 그동안 전달 유실 0, 순서 뒤집힘 0이었고 옮긴 뒤 행 수와 체크섬이 일치했습니다.
- 과거 데이터를 복사하는 백필의 상한은 초당 1만 행으로 정했습니다. 이 속도에서 전달 p95는 3회 중앙값으로 평시의 1.31배였고 상한을 풀자 7.4초와 19.5초까지 늘었습니다.
- 새 메시지를 양쪽 DB에 함께 쓰는 이중 쓰기는 삽입만 복제하므로 읽음, 수정, 삭제는 새 DB에서 어긋납니다. 채팅방 화면의 메시지 목록 조회를 양쪽 DB에 보내 비교하는 섀도 리드로 이 어긋남을 쟀고 재동기화로 불일치를 0으로 만든 뒤 읽기를 새 DB로 돌렸습니다.
- 섀도 리드를 준비하고 돌리는 동안 예정에 없던 결함 둘을 찾았습니다. 메시지 번호 중복과 DB에 적용된 적이 없던 읽음 표시입니다.
- 마지막으로 정본을 새 DB로 넘겼습니다. 정본은 저장과 중복 전송 판정의 기준이 되는 DB입니다. 쓰기를 막은 시간은 473ms였고 그 실행에서 보낸 1,200건은 유실 0이었습니다. 되돌림도 한 번 해 봤고 쓰기를 352ms 막은 뒤 양쪽 DB의 154,830행이 일치했습니다.
1번과 2번은 310만 행 데이터에서 쟀고 3번부터 5번은 그날 새로 넣은 약 14만 행 데이터에서 쟀습니다. 전부 한 기계의 서버 프로세스 둘과 로컬 PostgreSQL 16에서 잰 값이고 장마다 조건을 적었습니다. 판정 기준은 재기 전에 이슈에 적어 두었습니다.
1. 무중단 이관은 네 단계이고 단계마다 잴 수치가 있습니다
가장 단순한 방법은 쓰기를 멈추고 복사한 뒤 다시 켜는 것입니다. 채팅에서는 복사하는 동안 메시지를 보낼 수 없어서 쓰지 않았습니다.
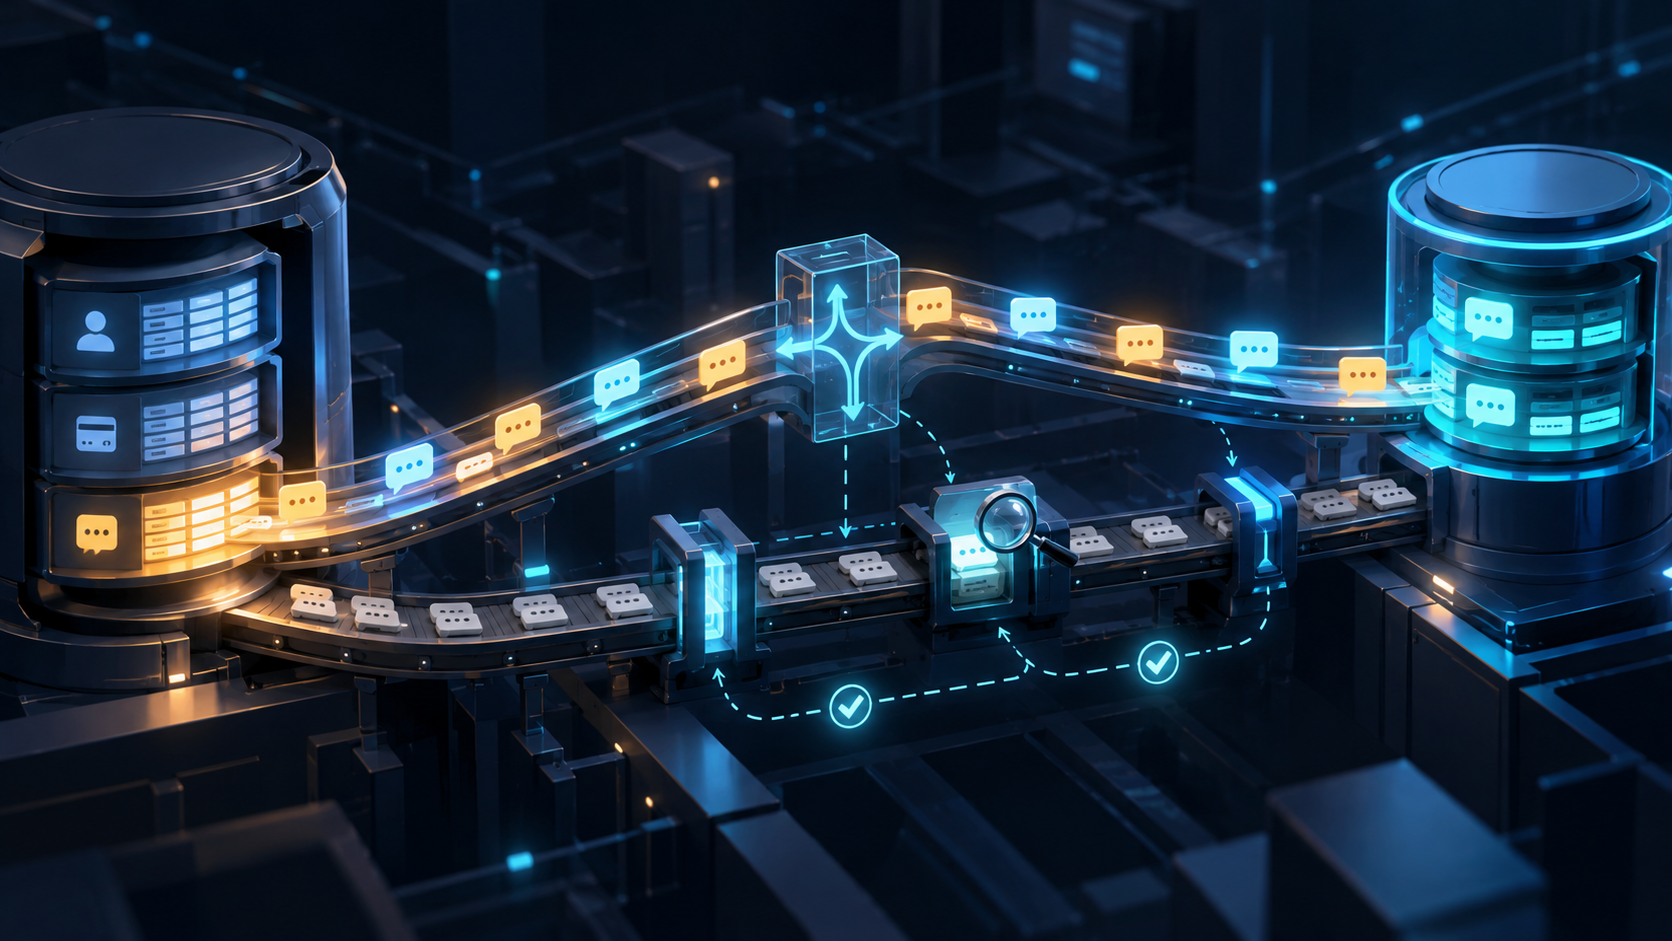
채팅을 켜 둔 채 옮기는 절차는 공개된 글에 있습니다. Discord는 수조 건의 메시지를 옮기면서 새 데이터를 두 DB에 함께 쓰고 과거 데이터를 뒤에서 옮긴 다음 읽기 일부를 양쪽에 보내 결과를 비교했다고 적었습니다. Slack도 Vitess로 옮기면서 애플리케이션이 이중으로 쓰는 동안 기존 테이블을 복제하는 백필과 양쪽을 읽어 비교하는 장치를 만들었다고 적었습니다. 단계로 적으면 아래와 같습니다.
- 새 메시지를 옛 DB와 새 DB에 함께 씁니다(이중 쓰기).
- 과거 데이터를 뒤에서 복사합니다(백필).
- 양쪽이 같은지 검증합니다.
- 읽기와 쓰기를 새 DB로 돌립니다(컷오버).
두 글에서 백필이 도는 동안 실시간 전달이 얼마나 밀리는지와 컷오버에서 쓰기를 몇 ms 막는지는 찾지 못했습니다. 옮기는 쪽은 이 두 수치가 있어야 백필 속도와 컷오버 시점을 정할 수 있어서 직접 쟀습니다.
앱과 앱 밖 스크립트가 맡을 일은 아래처럼 나눴습니다.
| 일 | 맡는 곳 | 이유 |
|---|---|---|
| 이중 쓰기 | 앱의 송신 경로(동기) | 비동기로 하면 새 DB 쓰기가 실패해도 드러나지 않습니다. 새 DB 쓰기가 실패해도 송신은 그대로 보내고 실패 횟수를 지표로 셉니다 |
| 백필 | 앱 밖 스크립트 | 백필은 실시간 전달과 같은 자원을 쓰므로 앱과 따로 속도를 조절합니다. 커서 기반이라 멈춘 자리에서 다시 시작합니다 |
| 검증 | 앱 밖 스크립트 | 행 수, 최근 1,000행 체크섬, 해시 표본 체크섬을 비교합니다 |
| 컷오버 | 앱과 스크립트 | 모든 노드에서 새 저장을 기다리게 하고(쓰기 배리어) 남은 행을 마저 복사한 뒤 전환합니다. 막은 시간이 5초를 넘으면 송신을 다시 열고 컷오버를 실패로 처리합니다 |
이 단계의 정본은 옛 DB이므로 이중 쓰기가 놓친 행은 검증에서 잡습니다. 백필과 이중 쓰기는 같은 행을 서로 다른 순서로 넣을 수 있는데 둘 다 ON CONFLICT (id) DO NOTHING이라 최종 상태가 같습니다.
2. 백필 상한은 초당 1만 행으로 정했습니다
백필은 실시간 전달과 같은 자원을 씁니다. 재기 전에 정한 기준은 전달 p95가 평시 5회 중앙값의 1.5배를 넘는 속도는 쓰지 않는다는 것입니다. 백필이 낼 수 있는 최대 속도는 상한 없이 15초 돌려 초당 약 2만 행으로 확인했고 5천, 1만, 무제한 세 단계를 쟀습니다. 아래는 단계마다 한 쌍이 주고받는 메시지 200건을 몰아 보내며 잰 전달 p95입니다.
| 단계 | 회차 | 전달 p95(회차별) | 중앙값 | 평시 대비 | 유실 · 뒤집힘 |
|---|---|---|---|---|---|
| 평시 | 5 | 988~1,596ms | 1,120ms | 1.00배 | 0 · 0 |
| 이중 쓰기 켬 | 5 | 1,157~1,698ms | 1,305ms | 1.17배 | 0 · 0 |
| 백필 5천 행/초 | 3 | 1,298~1,728ms | 1,318ms | 1.18배 | 0 · 0 |
| 백필 1만 행/초 | 3 | 1,313~1,963ms | 1,462ms | 1.31배 | 0 · 0 |
| 백필 무제한(실효 약 2만 행/초) | 2 | 7,398ms와 19,525ms | 내지 않음 | 6.6배 이상 | 0 · 0 |
서버 프로세스는 둘이고 옛 DB는 메인 PostgreSQL 16, 새 DB는 전용 PostgreSQL 16입니다. 무제한 단계의 세 번째 회차는 백필이 측정보다 먼저 끝나서 판정에서 뺐습니다. 같은 기계에서 도커 VM과 다른 도구가 돌아 단계 시작 때 부하 평균이 12에서 28까지 출렁였고 회차마다 기록했습니다.
1만 행/초는 세 회차 가운데 하나가 1,963ms로 평시의 1.75배였고 중앙값으로는 1.31배입니다. 이슈의 이중 쓰기 기준이 5회 중앙값을 쓰므로 백필 단계도 회차 중앙값으로 읽었습니다. 그렇게 읽어 5천과 1만을 받아들였고 무제한은 기각했습니다. 기준 안에 든 속도 가운데 가장 빠른 초당 1만 행을 상한으로 정했습니다. 1만과 무제한 사이의 속도는 재지 않았습니다.
이 상한으로 3,102,528행을 333초에 옮겼고 실효 속도는 초당 9,316행이었습니다. 옮기는 동안 잰 두 회차의 전달 p95는 1,335ms와 1,292ms입니다. 다 옮긴 뒤 쓰기 배리어를 올려 남은 행이 0인 것과 양쪽의 마지막 id가 같은 것을 확인하고 내리는 데 445ms가 걸렸습니다.
상한을 풀어 전달이 19.5초까지 밀린 회차에서도 유실과 순서 뒤집힘은 0이었습니다. 이 조건에서는 백필이 전달을 늦추기만 했고 메시지를 잃거나 순서를 바꾸지는 않았습니다.
옮긴 뒤 검증은 행 수(양쪽 3,103,147행), 최근 1,000행 체크섬, 해시 표본 12,152행 체크섬으로 했습니다. 이슈에 처음 적은 표본은 무작위 1,000행이었습니다. 무작위로 뽑으면 양쪽 DB가 서로 다른 행을 뽑아 비교가 되지 않아서 md5(id)의 접두사로 양쪽에서 같은 행을 고르는 방식으로 바꿨습니다. 대상 규모도 계획한 50만 행에서 310만 행으로 늘렸습니다.
이중 쓰기 자체의 비용은 건당 p50 0.75ms, p95 1.3ms였고 실패는 0이었습니다. 두 DB가 같은 기계에 있을 때의 수치여서 두 DB 사이에 프록시로 왕복 지연을 넣어 다시 쟀습니다.
| 왕복 지연 | 이중 쓰기 p95(건당) | 전달 p95 |
|---|---|---|
| 0ms(프록시만) | 3.8ms | 2,158ms |
| 5ms | 8.1ms | 2,987ms |
| 30ms | 34.6ms | 8,325ms |
이슈에 적은 기준은 전달 p95가 평시 1,120ms의 1.5배(1,680ms) 이내였는데 프록시만 끼운 조건이 이미 2,158ms로 이 기준을 넘었습니다. 프록시를 거치는 비용과 그때의 부하가 섞인 수치여서 지연의 효과는 같은 표의 0ms와 비교했습니다. 왕복 30ms의 전달 p95는 그 3.9배입니다. 방마다 메시지를 차례로 처리하는 큐가 있어서 건당 34.6ms가 몰린 송신 200건에 쌓이면 약 6.9초가 되고 잰 8.3초와 맞는 크기입니다. 큐에 쌓인 시간을 따로 잰 것은 아닙니다. 왕복 30ms급 원격에서는 동기 이중 쓰기를 쓸 수 없다고 판정했습니다. 다음 후보는 비동기로 쓰고 전달을 확인하는 방식과 묶어서 쓰는 방식이고 둘 다 아직 재지 않았습니다.
3. 읽기는 섀도 리드의 불일치가 0이 된 뒤에 돌렸습니다
이중 쓰기는 삽입만 새 DB에 복제합니다. 읽음 표시, 수정, 삭제는 옛 DB에만 적용되어 새 DB의 행이 옛 DB와 달라집니다. 읽기를 새 DB로 돌리기 전에 이 어긋남이 얼마나 되는지부터 쟀습니다.
잰 방법이 섀도 리드입니다. 채팅방 화면의 메시지 목록 조회에 옛 DB로 답하면서 같은 조회를 새 DB에도 보내 결과를 비교하고 불일치를 지표로 셉니다. 응답은 옛 DB의 것을 그대로 쓰므로 사용자가 받는 결과는 바뀌지 않습니다. 비교는 전용 스레드 하나와 길이 100의 큐에서 하고 큐가 차면 비교를 버린 뒤 버린 수를 셉니다.
데이터는 그날 새로 넣은 144,380행이고 새 DB는 2장과 다른 전용 PostgreSQL 16입니다. 비교는 첫 페이지와 앞뒤 커서를 섞은 조회 10종으로 했습니다.
- 읽음 처리 49,997행, 수정 3건, 삭제 3건을 실제 클라이언트 경로로 만든 뒤 비교 10건이 모두 불일치였습니다.
- 옛 DB의 읽음, 수정, 삭제 상태를 새 DB에 다시 맞추는 재동기화를 돌리자(50,000행 갱신) 같은 비교 10건에서 불일치가 늘지 않았습니다.
- 그 상태에서 목록 조회를 새 DB로 돌렸습니다. 같은 조회 10개의 응답 데이터가 모두 같았습니다. 응답에 함께 실리는 생성 시각은 비교에서 뺐습니다.
속도 기준은 전환 후 목록 조회 p95가 옛 경로의 2배 이하였습니다. 조회를 30회씩 두 회차 잰 p95입니다.
| 회차 | 옛 경로 첫 페이지 | 새 경로 첫 페이지 | 옛 경로 이전 페이지 | 새 경로 이전 페이지 |
|---|---|---|---|---|
| 1(워밍 1회) | 12.6ms | 26.4ms | 9.4ms | 7.7ms |
| 2(워밍 3회) | 11.0ms | 8.3ms | 9.9ms | 7.6ms |
회차 1의 첫 페이지는 2.10배로 기준을 넘었습니다. 이슈에는 기준이 하나라도 깨지면 옛 경로로 되돌린다고 적어 두었으므로 원래 기준대로면 되돌려야 하는 결과입니다. 회차 1만 재기동 뒤 워밍을 한 번 했고 회차 2는 세 번 했습니다. 회차 2에서는 새 경로가 옛 경로의 0.75배와 0.77배였습니다. 저는 회차 1의 초과를 워밍 차이로 보고 전환을 유지했습니다. 결과를 본 뒤에 내린 판단이고 워밍 차이가 원인인지 가르는 실행은 하지 않았습니다.
읽기를 돌리고 나면 옛 DB에서 지운 메시지가 재동기화 전까지 새 DB 읽기에 보입니다. 그래서 삭제, 수정, 읽음은 변경 시점에 새 DB에도 함께 쓰도록 바꿨습니다.
이 과정에서 예정에 없던 결함 둘을 찾았습니다.
하나는 메시지 번호 중복입니다. 어긋남을 만들기 전의 첫 비교가 이미 불일치였습니다. 메시지 번호는 방마다 Redis INCR로 매기는데 실험 데이터를 넣는 스크립트가 DB에 번호를 직접 넣고 Redis의 번호는 올려 두지 않았습니다. 그 뒤에 실제로 보낸 360건이 이미 있는 번호를 다시 받았고 번호가 같은 메시지는 정렬 순서가 조회마다 달라졌습니다. Redis의 번호가 사라지면 번호가 겹칠 수 있다는 것은 이슈로 적어 둔 예측이었고 이번에 실물로 확인했습니다. 이번 원인은 실험 스크립트였고 스크립트가 Redis의 번호를 맞추도록 고쳤습니다.
다른 하나는 읽음 표시입니다. 어긋남을 만들려고 읽음 처리를 클라이언트 경로로 돌리다가 읽음 표시가 DB에 적용되지 않고 있다는 것을 찾았습니다. 읽음 처리가 도는 비동기 스레드에 트랜잭션이 없어 매번 예외가 났고 그 예외를 삼키는 코드가 있었습니다. 양쪽 DB가 똑같이 틀려 있어서 섀도 비교로는 잡히지 않는 결함입니다. 비교할 데이터를 실제 경로로 만들다가 드러났습니다.
4. 정본은 쓰기를 473ms 막은 사이에 넘겼습니다
읽기를 돌린 뒤에도 정본은 옛 DB입니다. 남은 단계는 송신 저장과 멱등 중재를 새 DB로 옮기는 쓰기 컷오버입니다. 멱등 중재는 같은 전송이 다시 와도 한 번만 저장하는 처리입니다.
어느 DB를 정본으로 쓸지는 노드마다 메모리에 들고 있는 저장 모드가 정합니다. 그래서 전환하는 동안 두 노드가 서로 다른 DB를 정본으로 쓰는 구간이 생기고 그 구간에 저장이 들어오면 같은 전송을 한 번만 저장하는 판정이 두 DB로 갈라질 수 있습니다. 이 구간을 없애려고 교대는 쓰기를 막은 동안에만 합니다. 스크립트가 모든 노드에 쓰기 배리어를 세워 새 저장을 기다리게 하고 남은 행을 마저 복사한 뒤 양쪽 DB의 마지막 id가 같은지 봅니다. 같으면 모드를 바꾸고 배리어를 내립니다. 다르면 모드를 바꾸지 않고 배리어만 내린 뒤 실패로 끝냅니다.
교대 뒤의 저장은 새 DB의 조건부 유니크 제약에 INSERT ... ON CONFLICT DO NOTHING으로 들어갑니다. 0행이 돌아오면 먼저 저장된 행을 읽어 중복 전송으로 처리합니다. 옛 DB에는 같은 행을 거꾸로 복제합니다(역방향 미러). 옛 DB가 모든 행을 계속 갖고 있으므로 되돌릴 때는 모드만 되돌리면 됩니다.
기준 넷을 재기 전에 이슈에 적었습니다. 아래는 기준과 결과입니다.
| 기준 | 결과 |
|---|---|
| 컷오버 전 과정 송신 유실 0, 뒤집힘 0, 배리어 2초 이하 | 배리어 473ms, 그 실행의 1,200건 유실 0, 뒤집힘 0 |
| 교대 후 전달 p95가 교대 전의 1.5배 이하 | 교대 전 63, 75, 77ms와 교대 후 80, 63, 79ms. 중앙값으로 1.05배 |
| 교대 후 멱등 재전송의 행 증가 0 | 같은 식별자 10개를 3번씩 보낸 30건이 저장 10건과 중복 판정 20건으로 처리, 양쪽 DB 모두 10행 증가 |
| 되돌림 배리어 2초 이하, 유실 0, 양쪽 일치 | 배리어 352ms, 유실 0, 행 수 154,830과 최근 1,000행, 해시 표본 일치 |
한 실행은 송신 8명이 150건씩 200ms 간격으로 보내는 약 30초(1,200건)이고 수신은 다른 노드에서 봤습니다. 데이터는 144,020행에서 시작해 측정이 끝났을 때 154,830행이었습니다. 새 DB는 메모리에 올린(tmpfs) 전용 PostgreSQL 16이고 들어오는 송신의 속도 제한은 껐습니다. 교대와 되돌림은 한 번씩 했습니다.
교대 전후의 전달 p95는 회차 폭(63~80ms)이 두 중앙값의 차이보다 큽니다. 교대 전에는 옛 DB에 한 번, 새 DB에 한 번 쓰고 교대 후에는 새 DB에 한 번, 옛 DB에 한 번 쓰므로 비슷할 것이라는 예상과 맞는 결과입니다.
교대한 뒤 되돌리기까지 새 DB를 정본으로 받은 메시지는 4,812행입니다. 송신 노드의 미러 횟수가 교대 때 5,298이었고 되돌릴 때 10,110이었습니다. 되돌린 뒤 양쪽 DB의 행 수가 154,830으로 같았으므로 이 행들은 옛 DB에도 들어가 있었습니다. 되돌림 수단을 유지하려면 쓰기를 계속 두 번 해야 합니다. 검색, 단건 조회, 답장 원본 조회가 아직 옛 DB를 보고 있어서 그동안은 어차피 끊을 수 없는 비용입니다.
마지막 id 비교에는 한계가 있습니다. 메시지 id는 무작위 UUID라서 새 행이 들어와도 가장 큰 id가 바뀌지 않을 수 있습니다. 실제로 교대 로그와 되돌림 로그에 찍힌 마지막 id가 같았습니다. 중간에 빠진 행은 이 비교로 잡지 못하고 배리어 밖에서 돌리는 전체 검증(행 수, 최근 1,000행, 해시 표본)이 잡습니다.
5. 치른 비용과 아직 하지 않은 것
- 이관 기간에는 송신마다 INSERT가 한 번 더 붙습니다. 같은 기계에서는 건당 p95 1.3ms였고 왕복 30ms 조건에서는 2장의 결과대로 동기 방식을 쓸 수 없습니다.
- 섀도 리드를 켜면 조회마다 새 DB 읽기 한 번과 비교 한 건이 더 생깁니다. 응답 경로 밖의 전용 스레드에서 하고 큐가 차면 비교를 버립니다.
- 역방향 미러가 실패해도 송신은 그대로 보내고 실패 횟수를 셉니다. 옛 DB의 장애가 송신을 막으면 정본을 옮긴 의미가 없기 때문입니다. 그래서 실패 지표가 0이 아니면 빠진 행을 메우고 전체 검증을 통과한 뒤에만 되돌리는 것을 운영 규칙으로 두었습니다. 지금 있는 백필은 옛 DB에서 새 DB 방향뿐이고 반대 방향으로 메우는 도구는 아직 없습니다. 미러 실패를 일부러 넣어 되돌림이 막히는지도 재지 않았습니다.
- 교대 뒤에는 수정, 삭제, 읽음을 새 DB에 쓰지 못하면 그 요청을 실패로 돌려줍니다. 실패를 세기만 하면 지운 메시지가 계속 읽히기 때문입니다. 그만큼 새 DB에 문제가 있을 때 수정, 삭제, 읽음 요청이 실패합니다.
- 검색, 단건 조회, 답장 원본 조회는 아직 옛 DB를 봅니다. 이 읽기를 다 옮겨야 역방향 미러를 끊고 옛 DB의 메시지 테이블을 지울 수 있습니다.
측정의 한계도 적습니다. 전부 한 기계의 프로세스 둘과 로컬 DB에서 쟀고 같은 기계에서 다른 컨테이너가 돌았습니다. 읽기 전환과 정본 교대는 약 14만 행에서 쟀으므로 310만 행에서 쓰기를 막아 본 것은 2장의 445ms 한 번입니다. 교대와 되돌림은 한 번씩 해서 배리어 시간의 분포는 모릅니다. 백필 단계는 3회씩이고 무제한은 2회입니다. 백필 완주 로그와 검증 출력처럼 파일로 남기지 않은 결과는 측정 문서에 적은 수치로만 남아 있습니다.
참고
- Discord: How Discord Stores Trillions of Messages
- Slack: Scaling Datastores at Slack with Vitess
- 측정 기록: 대화가 진행되는 동안 메시지 저장소를 통째로 옮겼다, 읽기 전환, 정본 교대
- 재기 전에 적은 기준: 이관, 되돌림과 원격 조건, 읽기 전환, 정본 교대

댓글
댓글 수정/삭제는 GitHub Discussions에서 가능합니다.