Spring 백엔드 개발자가 성능 지표를 읽는 법
목차
성능 지표는 요청 하나가 시스템을 지나가며 남긴 숫자라서 서로 이어져 있습니다. 백엔드 개발을 하다 보면 이런 말을 자주 접합니다.
- “p99 latency가 튄다.”
- “throughput이 더 이상 안 나온다.”
- “connection pool이 포화됐다.”
- “CPU utilization은 낮은데 saturation이 발생했다.”
- “cache hit rate가 떨어졌다.”
- “동시성을 높였더니 오히려 느려졌다.”
처음에는 각각 별개의 용어처럼 보입니다. 성능 테스트나 장애 분석을 해 보면 한 숫자가 움직일 때 앞뒤 숫자가 같이 움직입니다. API 하나가 느려지는 경우를 그리면 이렇습니다.
이 글은 지표마다 어디에서 만나고 다른 지표와 어떤 관계가 있는지를 Latency → Throughput → Concurrency → Connection Pool → Cache → CPU → Availability 순서로 정리합니다.
1. Latency는 요청 하나가 끝나기까지 걸린 시간입니다
Latency는 어떤 작업을 시작한 뒤 결과를 얻기까지 걸린 시간입니다. Spring MVC API라면 가장 익숙한 형태는 이렇습니다.
Client가 요청을 보내고 응답을 받기까지 120ms가 걸렸다면 이 요청의 latency는 120ms입니다.
Spring Boot Actuator를 붙이면 Spring MVC와 WebFlux 요청에 대해 http.server.requests라는 metric이 기본으로 생성됩니다. Prometheus와 Grafana로 API 응답 시간을 볼 때 읽는 값이 이것입니다.
분포는 p50, p95, p99로 읽습니다
요청 여덟 건의 시간이 이렇게 나왔다고 해봅시다.
평균은 약 131ms입니다. 일곱 건은 20ms대에 끝났고 한 건은 900ms가 걸렸으니 131ms를 겪은 사용자는 없습니다. 그래서 서버에서는 percentile을 씁니다.
| 지표 | 읽는 법 |
|---|---|
| p50 | 요청의 절반이 이 시간 안에 끝났습니다 |
| p95 | 요청의 95%가 이 시간 안에 끝났고 느린 5%는 이 값을 넘었습니다 |
| p99 | 느린 1%가 넘긴 시간입니다 |
p50 = 30ms, p95 = 120ms, p99 = 850ms라면 요청의 절반은 30ms 안에 끝나고 100건 중 한 건은 850ms를 넘는다는 뜻입니다.
Spring에서 percentile을 볼 때 확인할 설정이 하나 있습니다. 애플리케이션이 직접 계산해 내보낸 p95는 인스턴스끼리 합칠 수 없습니다. 서버 세 대의 p95를 평균 낸 값은 전체 요청의 p95와 다른 숫자입니다. Micrometer 문서는 Prometheus를 쓴다면 histogram bucket을 내보내고 조회할 때 percentile을 계산하라고 권합니다.
management.metrics.distribution.percentiles-histogram.http.server.requests=trueSpring 백엔드에서 latency가 붙는 자리
- API 응답 시간
- 외부 API 호출 시간
- Redis GET latency
- SQL query latency
- DB connection acquisition time
- Kafka produce/consume 처리 시간
- lock wait
- GC pause
- 부하 테스트의 p95/p99
그래서 “API가 느리다”는 말을 들으면 전체 latency 중 어느 구간에서 시간이 쓰였는지를 먼저 묻습니다.
2. Throughput은 일정 시간 동안 처리한 양입니다
Latency가 요청 하나의 시간이라면 throughput은 일정 시간 동안 처리한 양입니다. 웹 서버에서는 흔히 RPS(Requests Per Second)를 씁니다.
DB에서는 TPS(Transactions Per Second), QPS(Queries Per Second) 같은 표현도 봅니다.
Latency와 throughput은 따로 움직입니다. 요청 하나를 10ms에 처리하지만 한 번에 하나만 처리하는 서버는 초당 100건이 한계입니다. 요청 하나에 50ms가 걸려도 200개를 동시에 처리하는 서버는 초당 4,000건을 처리합니다.
그래서 성능 테스트 결과에 “응답 시간이 100ms입니다”만 적으면 부족합니다. 최소한 이 정도는 함께 적습니다.
| 지표 | 값 |
|---|---|
| Traffic | 1,000 RPS |
| p50 | 35ms |
| p95 | 120ms |
| p99 | 430ms |
| Error Rate | 0.1% |
3. 묶어서 처리하면 throughput을 얻고 latency를 냅니다
Latency와 throughput이 부딪히는 대표적인 자리가 batching입니다.
요청을 받는 대로 처리하면 기다리는 시간이 짧습니다. 여러 작업을 모아 한 번에 보내면 DB round trip과 작업 비용이 줄어 전체 throughput이 오릅니다. 그 대가로 먼저 온 요청은 batch가 만들어질 때까지 기다립니다.
하나를 얻으면서 다른 비용을 내는 구조입니다.
4. Concurrency는 진행 중인 작업이고 parallelism은 같은 순간에 실행되는 작업입니다
Concurrency는 여러 작업이 같은 시간 구간에 진행 중인 상태입니다. Parallelism은 여러 작업이 같은 순간에 실제로 실행되는 것입니다. 4 Core CPU로 보면 이렇습니다.
왼쪽은 Core 네 개가 작업 네 개를 같은 순간에 실행하는 parallelism입니다. 오른쪽은 한 순간에는 하나만 실행하면서 여러 작업을 번갈아 진행시키는 concurrency입니다.
Spring에서는 이 개념이 아래 자리마다 등장합니다.
HTTP RequestThread PoolVirtual Thread@AsyncCompletableFutureWebClientDB Connection PoolKafka ConsumerBatch WorkerScheduler동시에 진행하는 작업 수를 계속 올리면 성능도 계속 좋아지는지가 다음 질문입니다.
5. 동시성을 올리면 처리량은 평평해지고 지연이 오릅니다
처음에는 concurrency를 높이면 CPU나 DB가 놀던 시간을 채울 수 있습니다. 어느 지점에서 시스템이 처리할 수 있는 한계에 닿습니다.
한계 전까지는 concurrency와 함께 throughput이 오릅니다. 자원이 포화되면 throughput은 더 늘지 않습니다. 기다리는 요청만 늘어 그림의 무릎 뒤로 latency가 치솟습니다.
그래서 “스레드를 100개에서 1,000개로 늘렸습니다”만으로는 개선인지 알 수 없습니다. 늘어난 1,000개가 어떤 자원을 기다리게 됐는지를 봐야 합니다.
6. 커넥션 풀이 꽉 차면 요청은 커넥션을 기다립니다
Spring에서 JPA나 JDBC를 쓰면 자주 만나는 대기가 DB connection입니다. Spring Boot는 DataSource마다 active, idle, maximum, minimum connection gauge를 jdbc.connections 접두사로 제공하고 HikariCP를 쓰면 hikaricp 접두사의 metric도 따로 제공합니다.
HikariCP의 maximum pool size가 10이라고 해봅시다.
pool이 maximum size에 도달하고 idle connection이 없으면 getConnection() 호출은 connection이 반환될 때까지 기다립니다. 이 시간이 connection wait입니다. connectionTimeout을 넘기면 예외로 끝납니다.
느린 요청 하나를 추적으로 열었더니 구간별 시간이 이랬다고 해봅시다.
| 구간 | 시간 |
|---|---|
| Connection Wait | 850ms |
| SQL Execution | 200ms |
| Others | 150ms |
| 요청 전체 | 1,200ms |
이 요청은 시간의 약 70%를 DB connection을 기다리는 데 썼습니다. Controller 코드를 최적화해서 줄일 수 있는 구간은 150ms 안쪽입니다. 커넥션 풀 자체는 DB 커넥션 풀 편에서 더 깊이 다뤘습니다.
구간별 시간은 요청 하나의 추적에서 읽습니다. 구간마다 따로 구한 p95는 서로 다른 요청에서 나온 값이라 더해도 전체 p95가 되지 않습니다.
7. 풀을 키우면 대기열이 DB로 옮겨 갑니다
maximumPoolSize를 10에서 50으로 올리면 애플리케이션에서 connection을 기다리는 요청은 줄어듭니다. DB 입장에서는 동시에 도는 쿼리 수가 10개에서 50개로 늘어납니다.
DB CPU, Disk I/O, lock contention, context switching이 함께 올라가고 query latency가 늘어날 수 있습니다.
애플리케이션에서 기다리던 요청이 DB 안에서 기다리게 되면 대기열의 위치만 바뀐 것입니다. HikariCP의 pool sizing 문서는 작은 풀에 스레드가 connection을 기다리며 줄을 서는 쪽을 권하고 예상 부하를 직접 걸어 풀 크기를 정하라고 적습니다.
풀 크기를 바꿀 때는 애플리케이션 쪽 지표 셋과 DB 쪽 지표 넷을 같이 봅니다.
Active ConnectionPending/WaitingConnection Acquisition Time
DB Query LatencyDB CPUDB Lock WaitDB I/O8. Cache hit rate는 DB까지 가지 않은 요청의 비율입니다
상품 조회가 100번 들어왔다고 해봅시다.
그중 90번을 Redis에서 찾았다면 Cache Hit Rate = 90%입니다. DB 부하를 줄이려고 캐시를 붙였다면 DB가 받는 요청 수를 이 값이 정합니다.
DB가 받는 쪽은 miss입니다. Hit rate가 95%에서 90%로 내려가면 숫자는 5%p 움직였지만 miss는 5%에서 10%로 두 배가 됩니다.
| 지표 | 전 | 후 |
|---|---|---|
| Cache Hit Rate | 95% | 90% |
| DB QPS | 500 | 1,000 |
| DB CPU | 40% | 80% |
| SQL p95 | 30ms | 180ms |
그래서 “DB가 갑자기 느려졌습니다”라는 상황의 원인이 DB 밖에 있을 수 있습니다. 캐시 hit rate가 먼저 떨어졌고 그 결과로 DB traffic이 늘어난 경우입니다. 캐시 계층은 Redis 캐싱 편에서 더 다뤘습니다.
9. Hit rate가 높아도 값 크기와 TTL에서 비용이 납니다
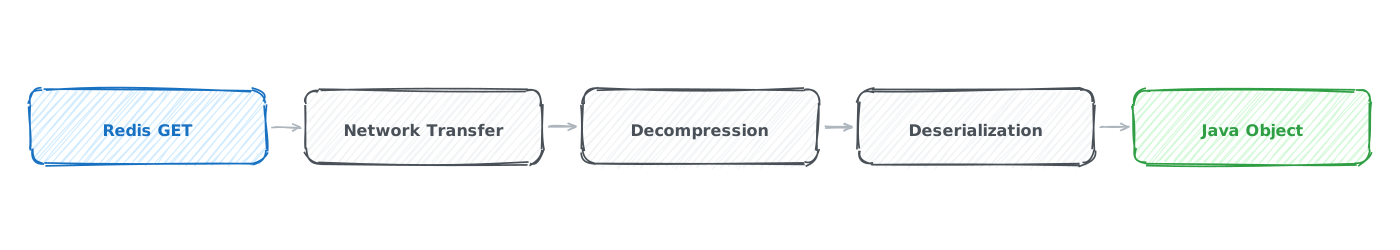
Hit rate가 99%여도 캐시 value 하나가 크면 hit 한 번에 드는 비용이 큽니다. Redis에서 꺼낸 값은 아래 단계를 모두 거쳐야 자바 객체가 됩니다.
TTL을 길게 잡아 hit rate를 올릴 때도 내는 것이 있습니다.
그래서 cache를 분석할 때는 hit rate와 함께 아래 값을 봅니다.
Hit RateCache GET LatencyValue SizeNetwork TrafficSerialization CostMemory UsageEviction10. Utilization은 쓰는 정도이고 saturation은 기다리는 정도입니다
Utilization은 CPU가 얼마나 사용되고 있는지를 나타내고 CPU Utilization = 70%처럼 읽습니다. Saturation은 CPU를 쓰려는 작업이 CPU를 받지 못해 기다리는 정도입니다.
위쪽 네 칸은 Core 네 개가 모두 일하고 있다는 뜻이니 utilization입니다. 아래쪽 다섯 개가 saturation입니다. CPU를 원하는 작업이 줄을 서기 시작했습니다.
Brendan Gregg의 USE Method는 자원마다 Utilization, Saturation, Errors를 함께 확인하라고 정리합니다. Saturation은 자원이 처리하지 못한 추가 작업이 쌓인 정도로 정의하고 그 작업은 대개 queue에 들어가 있다고 설명합니다.
11. 평균 CPU 70%는 짧은 포화를 가립니다
“CPU가 70%니까 CPU 문제는 아니다”라는 판단은 평균을 낸 구간이 길수록 틀리기 쉽습니다. 모니터링 시스템이 5분 평균을 보여준다고 해봅시다.
몇 초 동안 CPU가 100%에 닿아 queue가 생겼어도 5분 평균은 70%로 보일 수 있습니다. USE Method 문서에도 모니터링 도구가 5분 평균을 보여 주는 동안 CPU 사용률이 몇 초씩 100%를 찍던 사례가 나옵니다.
그래서 CPU는 아래 값을 이어서 봅니다.
CPU UtilizationCPU Run QueueScheduler LatencyLoadContext SwitchApplication Latency12. Availability는 요청을 받는지를 보고 reliability는 맞게 처리하는지를 봅니다
Availability는 사용자가 서비스를 사용할 수 있는지에 초점을 둡니다. 서비스가 요청을 받아 응답하는 상태인지를 봅니다. Reliability는 서비스가 일정 기간 동안 의도한 동작을 올바르게 수행하는지에 가깝습니다. 결제 서버로 보면 차이가 드러납니다.
두 요청 모두 200 OK를 받았고 HTTP 서버는 살아 있습니다. 아래쪽 요청은 승인 기록이 남지 않았으니 사용자가 기대한 결제는 수행되지 않았습니다. Google SRE Book도 오류를 셀 때 HTTP 500 같은 명시적 실패와 함께 200을 돌려주면서 내용이 틀린 응답을 암묵적 실패로 넣습니다.
그래서 운영에서는 uptime과 함께 아래 값을 봅니다.
Error RateTimeoutCorrectnessDuplicate ProcessingData ConsistencyRetryRecovery13. 장애 하나에서 지표가 이어지는 순서
상품 조회 API의 p95 latency가 100ms → 1,800ms가 되었다고 해봅시다. 처음 본 것은 latency이고 그다음에 traffic을 확인합니다.
RPS500 → 500트래픽은 그대로입니다. 애플리케이션 CPU도 여유가 있습니다.
Application CPU45%HikariCP를 보면 풀이 꽉 차 있습니다.
Active Connection30 / 30
Pending45
Connection Wait900msDB까지 간 요청 하나를 추적으로 열면 구간이 이렇게 나뉩니다.
시간의 절반이 커넥션 대기이니 “Connection Pool이 부족하다. 30에서 100으로 올리자”는 결론이 먼저 떠오릅니다. 그 전에 DB를 확인합니다.
DB CPU50% → 95%
SQL20ms → 600ms커넥션을 오래 쥐게 만든 것은 느려진 쿼리였습니다. 조금 더 거슬러 올라가면 캐시가 나옵니다.
Cache Hit Rate95% → 90%Hit rate는 5%p 내렸고 DB로 가는 요청은 초당 25건에서 50건으로 두 배가 됐습니다. 전체 흐름은 이렇습니다.
API latency는 결과였고 connection pool saturation은 중간 증상이었습니다. 앞쪽 원인은 cache miss 증가였습니다.
대기 건수는 처리량과 대기 시간의 곱으로 맞춰 봅니다
위 숫자들은 서로 계산이 맞습니다. Connection 30개가 각각 600ms짜리 쿼리를 쥐고 있으면 풀을 지나가는 요청은 초당 50건(30 ÷ 0.6초)입니다. Miss로 DB에 가는 요청도 초당 50건(500 RPS × 10%)이라 풀이 겨우 따라가는 상태입니다. 대기 중인 45건은 초당 50건씩 빠지니 평균 0.9초를 기다립니다.
진행 중인 건수가 처리량에 머문 시간을 곱한 값과 같다는 이 관계가 Little’s law입니다. 대시보드에서 세 값 중 둘을 읽으면 나머지 하나를 계산할 수 있습니다. 계산한 값과 대시보드의 값이 어긋나면 어느 지표의 뜻을 잘못 알고 있는지부터 봅니다.
풀을 100으로 올리면 대기 0.9초가 SQL 시간으로 옮겨 갑니다
풀을 30에서 100으로 올리는 안도 같은 식으로 미리 따져 볼 수 있습니다. 지금 DB 쪽에 걸려 있는 요청은 실행 중 30건과 대기 45건을 합쳐 75건입니다. 풀을 100으로 올리면 75건이 모두 DB 안으로 들어갑니다. DB가 끝내는 양이 초당 50건 그대로라면 쿼리 하나는 1.5초(75 ÷ 50)가 걸립니다. 풀 대기 0.9초와 SQL 0.6초를 더한 1.5초와 같은 값입니다.
풀 대기는 사라지고 요청이 걸리는 시간은 그대로입니다. 실제로는 동시에 도는 쿼리가 늘면 context switching과 lock 경합이 더해져 DB가 끝내는 양이 줄 수 있습니다. 이 장애에서 손댈 곳은 hit rate가 떨어진 이유입니다.
14. 서비스는 RED로 보고 자원은 USE로 봅니다
두 가지 틀을 같이 기억하면 편합니다.
RED는 Tom Wilkie가 마이크로서비스를 보려고 만든 틀이고 서비스마다 Rate, Errors, Duration을 봅니다. Spring API라면 RPS, HTTP 5xx, p50 / p95 / p99가 여기에 해당합니다. 문제가 아래 계층으로 내려가면 CPU, Memory, Disk, Network, Connection Pool, Thread Pool 같은 자원마다 Brendan Gregg의 USE대로 Utilization, Saturation, Errors를 확인합니다.
Google SRE Book의 golden signal 네 가지는 Latency, Traffic, Errors, Saturation입니다. RED에 saturation을 더한 구성과 같습니다.
15. 장애에서는 요청이 기다리는 자리를 찾습니다
이 순서에서 중심이 되는 질문은 하나입니다.
요청은 지금 어디에서 기다리고 있는가?
후보는 CPU, DB connection, DB lock, 외부 API, Redis 응답, thread pool의 실행 순서입니다. 하나씩 확인해 가면 “서버가 느립니다”가 “DB connection을 평균 0.9초 기다립니다” 같은 문장으로 바뀝니다.
화면이 느리다는 신고에서 시작했다면 브라우저 쪽 구간부터 나눕니다. 그 순서는 느린 UI는 어디서 느린가에 따로 적었습니다.
16. 개선 전후는 같은 부하에서 여러 지표로 비교합니다
최적화 후 “CPU 사용률이 78%에서 41%로 내려갔다”고 합시다. 이것만으로는 좋은 결과인지 알 수 없습니다. Throughput이 같이 절반으로 떨어졌어도 같은 숫자가 나옵니다.
그래서 같은 workload에서 비교합니다.
| 지표 | Before | After |
|---|---|---|
| RPS | 1,000 | 1,000 |
| p50 | 35ms | 24ms |
| p95 | 180ms | 90ms |
| p99 | 600ms | 210ms |
| CPU Utilization | 78% | 41% |
| CPU Queue | 3.2 | 0.4 |
| DB Active Conn | 28/30 | 14/30 |
| Conn Wait p95 | 85ms | 2ms |
| Cache Hit Rate | 70% | 94% |
같은 1,000 RPS를 처리하면서 CPU 사용률, CPU 대기, DB connection 대기, tail latency가 함께 내려간 것을 확인해야 개선이라고 말할 수 있습니다.
17. 성능 튜닝은 얻는 것과 내는 것을 함께 정하는 일입니다
성능 용어를 공부하면서 크게 느낀 점은 거의 모든 결정에 반대쪽 비용이 있다는 것입니다.
그래서 성능 테스트 결과에는 무엇을 개선했는지, 그 대가로 무엇이 나빠졌는지, 지금 workload에서 그 교환을 받아들일 만한지를 함께 적습니다. 장애 상황에서는 요청이 지금 어디에서 기다리고 있는지부터 봅니다.
이 두 가지를 기준으로 보면 latency, throughput, concurrency, cache hit rate, connection wait, CPU saturation은 요청 하나가 시스템을 지나가며 남긴 이어진 숫자로 읽힙니다.
참고
- 자원을 Utilization, Saturation, Errors로 나눠 보는 틀과 5분 평균 사례: The USE Method (Brendan Gregg)
- 서비스를 Rate, Errors, Duration으로 보는 틀: The RED Method: How to Instrument Your Services (Grafana Labs)
- Golden signal 네 가지와 200 응답 속 암묵적 오류: Google SRE Book · Monitoring Distributed Systems
- 풀을 작게 두고 부하를 걸어 크기를 정하라는 근거: HikariCP · About Pool Sizing
http.server.requests, 커넥션 풀 지표, percentile histogram 설정: Spring Boot Actuator metrics- 애플리케이션이 계산한 percentile을 합칠 수 없는 이유: Micrometer · Histograms and Percentiles
- tail latency가 평균과 다른 이유: The Tail at Scale (Dean & Barroso)

댓글
댓글 수정/삭제는 GitHub Discussions에서 가능합니다.