b-studio: 사내 도구를 만들고 바로 실행해 보는 AI 앱 빌더
b-studio는 요청을 말하면 코딩 에이전트가 프론트엔드와 백엔드 코드를 쓰고, 그 코드를 격리된 샌드박스에서 실제 서버로 띄워 검증까지 하는 AI 앱 빌더다. 에이전트가 만든 코드를 어떻게 믿게 했는지와 직접 실행하는 방법을 다룬다.
검색 결과가 없습니다
제목, 태그, 카테고리로 검색
b-studio는 요청을 말하면 코딩 에이전트가 프론트엔드와 백엔드 코드를 쓰고, 그 코드를 격리된 샌드박스에서 실제 서버로 띄워 검증까지 하는 AI 앱 빌더다. 에이전트가 만든 코드를 어떻게 믿게 했는지와 직접 실행하는 방법을 다룬다.
이미 쓰던 Claude 구독을 폰에서도 쓰고 싶어서 만든 봇이다. API 키로 따로 과금하는 대신 Claude Code 구독 인증(claude -p)을 그대로 호출하고, 메시지를 보내면 작업 과정을 실시간으로 흘려줍니다. 디스코드 봇을 이미 돌리고 있으면서도 이번엔 텔레그램을 고른 이유, 코딩 모드에서 확인 없이 파일을 고치는 대신 넣은 취소 장치, 같은 서버의 다른 서비스를 못 건드리게 막은 격리까지 정리했다.
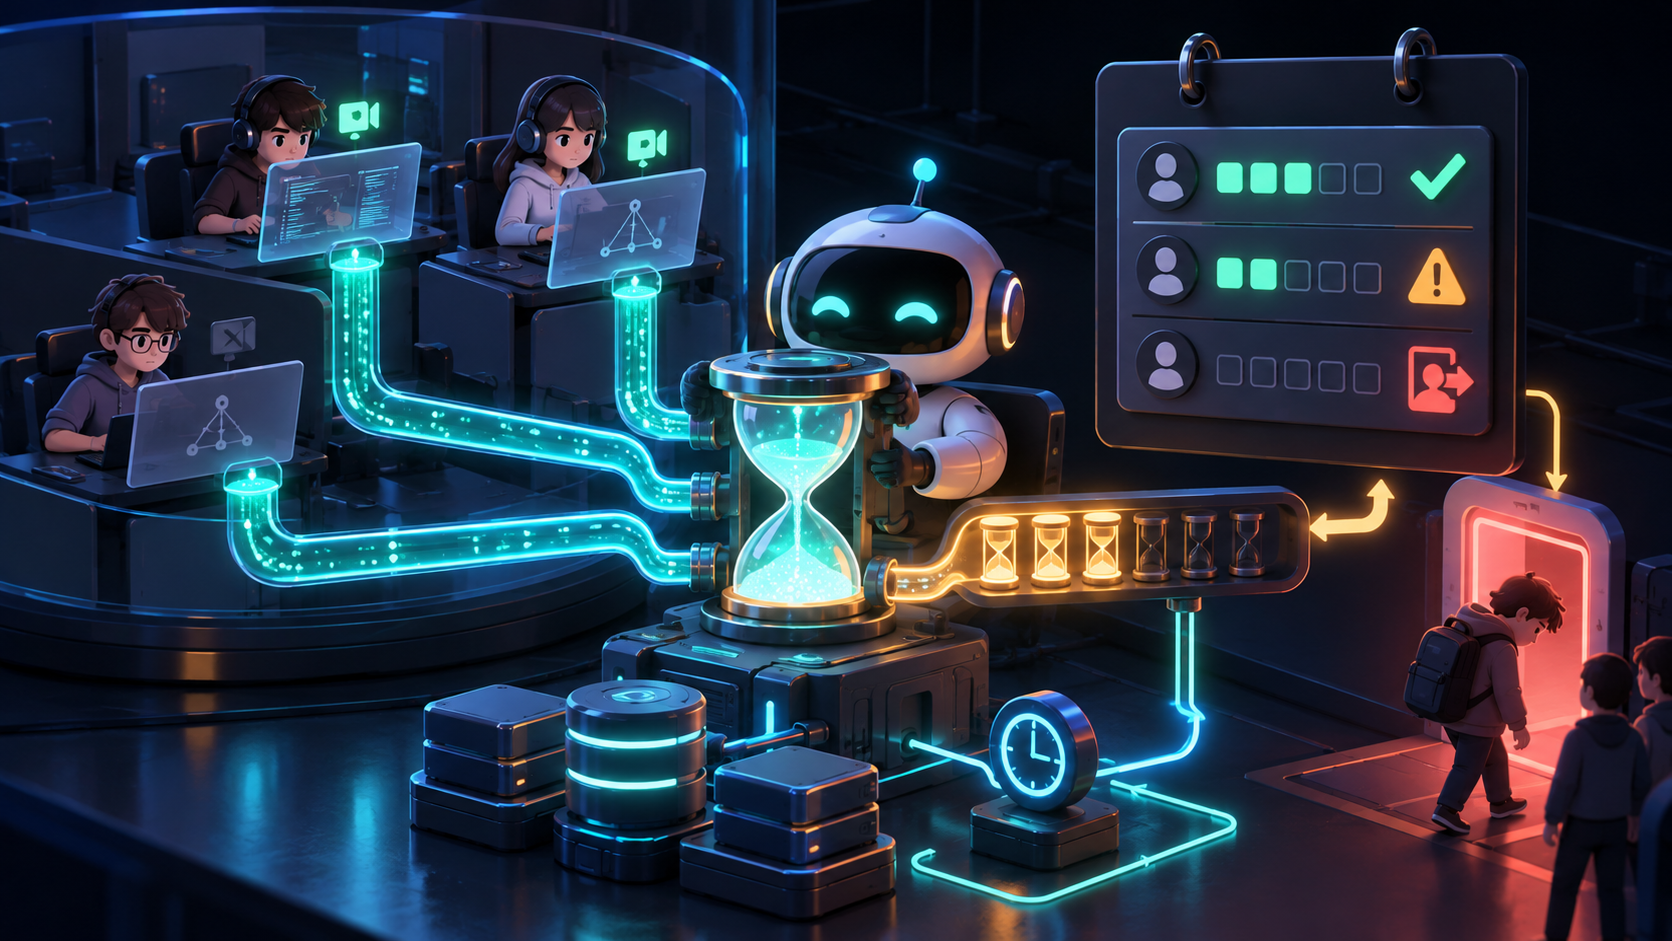
알고리즘 스터디의 출석 체크를 봇에게 넘긴 기록이다. 음성채널에 들어와 있는 시간이 아니라 화면 공유를 켠 시간만 구간 합산으로 세고, 누적 60분이면 출석, 주 3회 미달이면 경고, 경고 3회면 자동으로 자리를 정리한다. 공지는 실시간이지만 판정은 정산 크론에서만 하도록 갈라 둔 덕에 봇이 재시작돼도 기록이 안 깨집니다. 후반부는 '시간대 제한을 풀고 24시간 돌리자'는 설정 한 줄짜리 변경인 줄 알았던 일이 함정 세 개(24:00이라는 크론에 없는 시각, 일요일 출석을 못 보는 주간 점검, DB에 남은 옛 세션 키로 죽는 재시작 복구)로 번진 이야기이다.
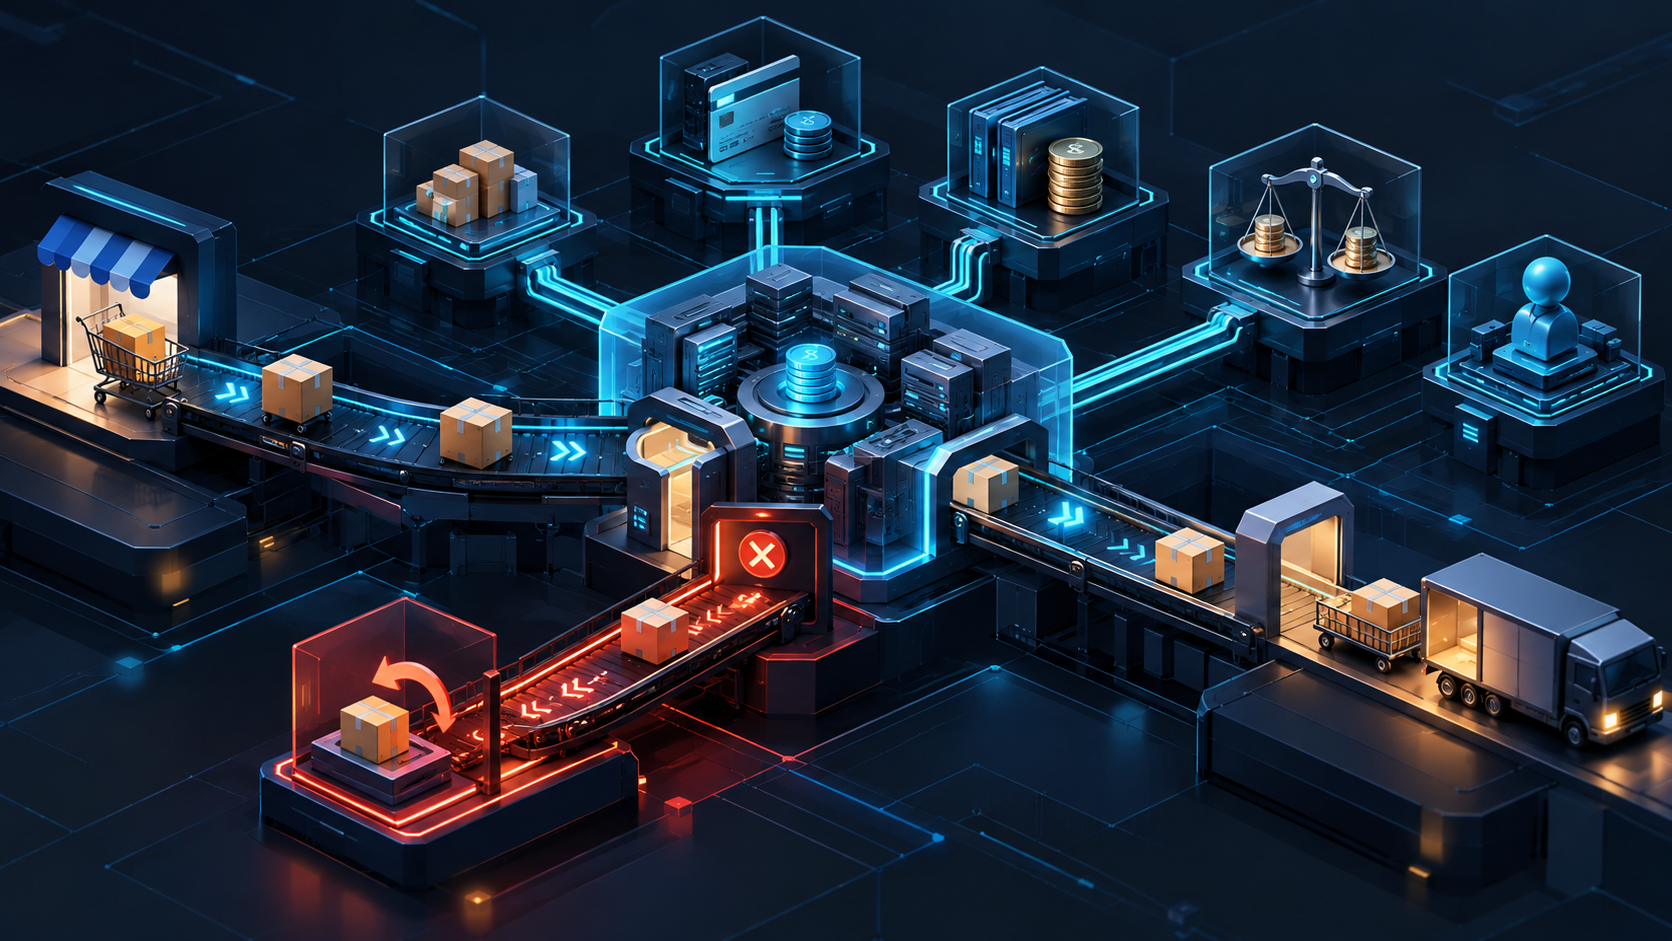
BE-commerce는 주문·결제·정산·대사·추천을 하나의 Spring Modulith 애플리케이션으로 구현한 이커머스 백엔드입니다. 기능 소개보다 실패를 재현하고 측정해 경계를 정한 글을 영역별로 모았습니다.
이 글은 db-hobby의 회고이자, 이 시리즈 전체의 포트폴리오다. 출발점은 하나의 자각이었다. '인덱스는 B+Tree라 빠르다'고 말할 수는 있는데, 왜 이진 트리가 아니라 B+Tree인지, 커밋의 fsync가 정확히 무엇을 보장하는지 설명하지 못했다. 설명할 수 없으면 모르는 것이다. 그래서 페이지 한 장부터 Raft 합의까지 C로 직접 만들었고, 모든 주장을 직접 측정한 수치로 바꿨다: 인덱스는 10만 행에서 풀 스캔보다 416배 빨랐고, 같은 5천 행 적재가 fsync 횟수에 따라 23배 갈렸고, 12코어 병렬화는 2.16배가 천장이었는데 그 천장의 정체(버퍼 풀 latch의 I/O 직렬화)를 A/B 실험으로 확증하고 고치자 콜드 스캔이 4워커 기준 1.08배에서 2.39배가 됐다(8워커는 0.62배에서 1.36배). 성능 작업 중 조용히 틀린 답을 내던 집계 버그를 발굴했고, 구현과 검증을 분리한 적대적 리뷰가 '테스트는 초록인데 원리상 틀린' 합의 버그 일곱을 잡았다. 694개 테스트, ThreadSanitizer/ASan 계측, 크래시 주입, 결정적 시뮬레이션. 무엇을 만들었는지가 아니라 어떻게 검증했고 왜 그 선택을 했는지의 기록이다. 무엇을 안 했는지(정직한 경계)까지 포함해서.
DBTower는 MySQL, PostgreSQL, SQL Server, Oracle, MongoDB를 한 화면에서 관제하고, 문제 쿼리를 진단하고, 승인된 변경만 되돌릴 사본과 함께 실행하는 셀프호스트 DB 운영 플랫폼이다. 안전을 지키는 방식과 직접 실행하는 방법을 다룬다.
나무위키+한국어 위키백과+영어 위키백과+뉴스+웹텍스트+C4 한국어 코퍼스 1,215만 건 검색 엔진 프로젝트를 2개월간 26편의 기술 블로그로 기록하고 총정리한다. MySQL LIKE 5,000ms 타임아웃에서 시작하여 임베디드 Lucene + Nori 한국어 형태소 분석으로 전환하고, Caffeine+Redis 2계층 캐시(82% 히트율), MySQL Replication R/W 분리, Nginx 스케일아웃(에러율 13.25%→0%), Debezium+Kafka CDC, Redis 3노드 Consistent Hashing까지 분산 아키텍처를 완성한다. 검색 품질은 동의어 확장, 오타 교정, UnifiedHighlighter snippet, LTR(NDCG +4.8%p), 카테고리 28개 자동 분류, Aho-Corasick 금칙어 필터링으로 고도화하고, RAG(Gemini SSE 스트리밍)로 AI 검색 요약을 제공한다. 자동완성 시스템 설계(CQRS + MapReduce + CDC)의 이론과 실제 구현의 매핑, 26편 전체 시리즈 링크, 핵심 수치 총정리를 포함한다.
LLM 워크플로우를 실행하고, 실패를 분석하고, 규칙을 자동 생성하고, 회귀 테스트까지 하나의 루프로 연결하는 평가 엔진.
IntelliJ와 VS Code에서 문제 가져오기, 로컬 테스트, 제출까지 한 번에 하는 코딩테스트 플러그인.
Astro 기반 정적 블로그를 직접 설계하고 구축한 과정. 직접 만든 이유와 기술 스택을 고른 기준을 다룬다.
위키엔진은 나무위키·위키백과·뉴스·웹텍스트 등 1,215만 건의 문서를 Lucene으로 색인하고 검색하는 개인 프로젝트다. 어떤 트레이드오프를 거쳐 지금 구조에 도달했는지와 실제 작업 일정을 다룬다.
발루노는 캐릭터 스탯, 무기 수치, 성장 곡선처럼 표에 쌓이는 게임 기획 데이터를 스프레드시트로 편집하고, 버전별 변경 이력과 몬테카를로 시뮬레이션까지 한곳에서 관리하는 1인 프로젝트다. 구조와 트레이드오프, 8개월 작업 기록을 다룬다.
타이미는 집중한 시간을 기록하고 그만큼 보상과 성장 요소를 주는 게이미피케이션 타이머다. 1인 개발자가 커밋과 이슈 기록으로 일정을 관리한 과정을 다룬다.
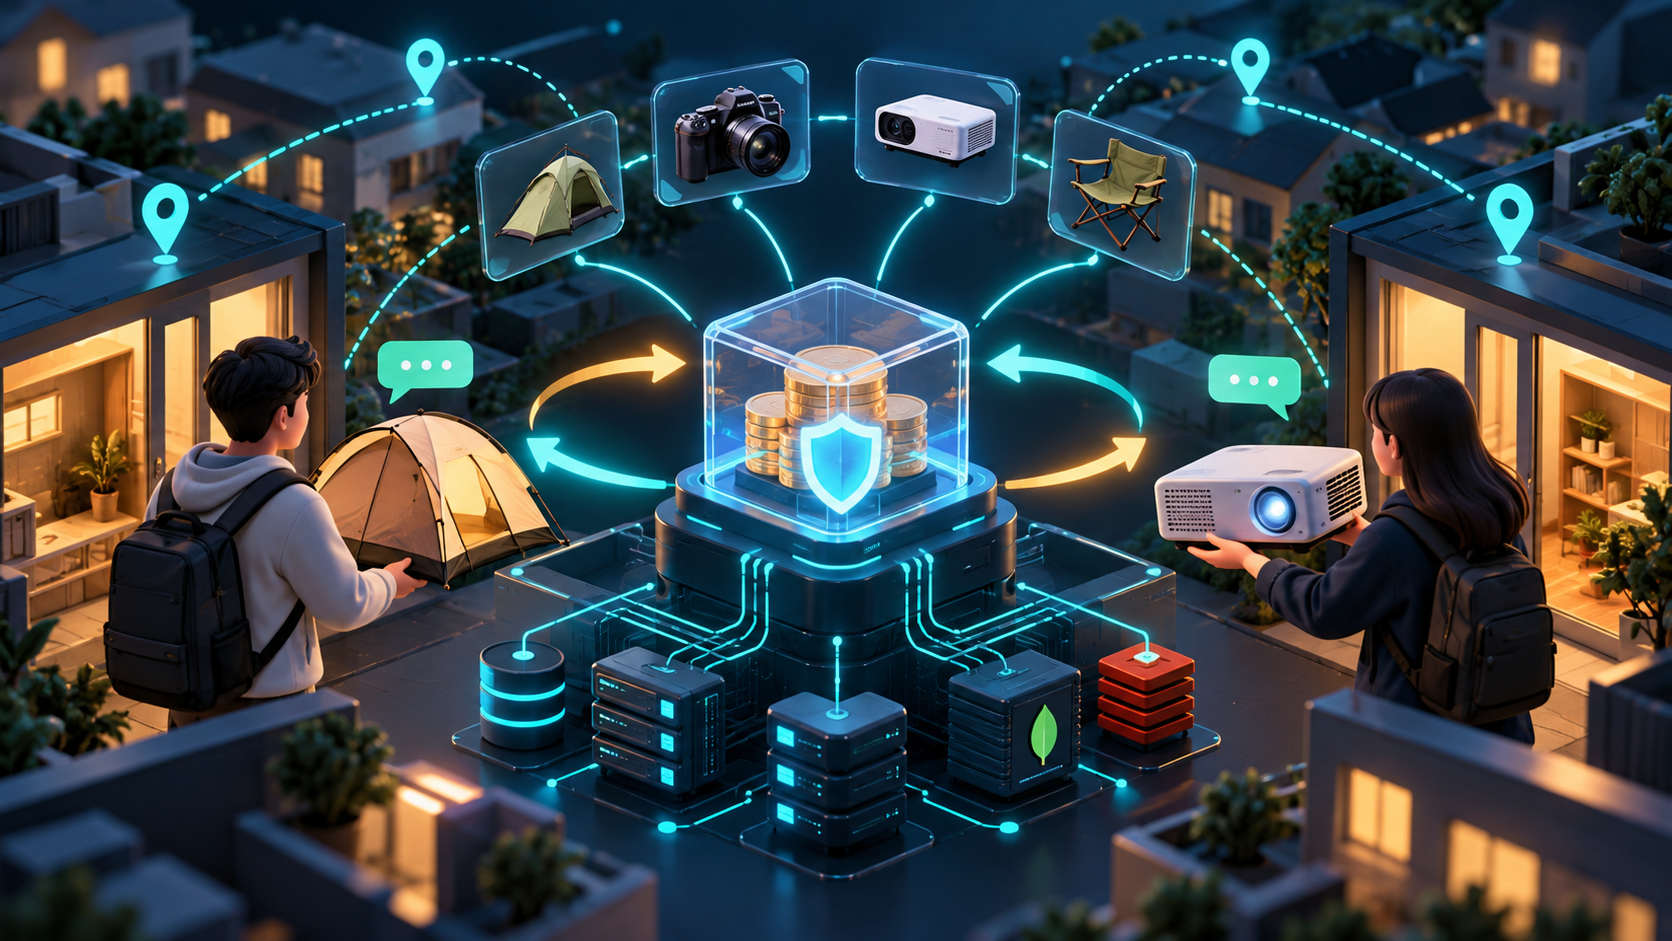
빌려조잉은 캠핑 텐트나 빔프로젝터처럼 한두 번 쓰고 방치되는 물건을 이웃끼리 빌리고 빌려주는 C2C 대여 플랫폼이다. SSAFY 6인 팀이 6주 동안 만들어 삼성전자 주식회사 프로젝트 우수상을 받았다. 6주를 어떻게 나눠 썼고 무엇을 맡았는지를 다룬다.
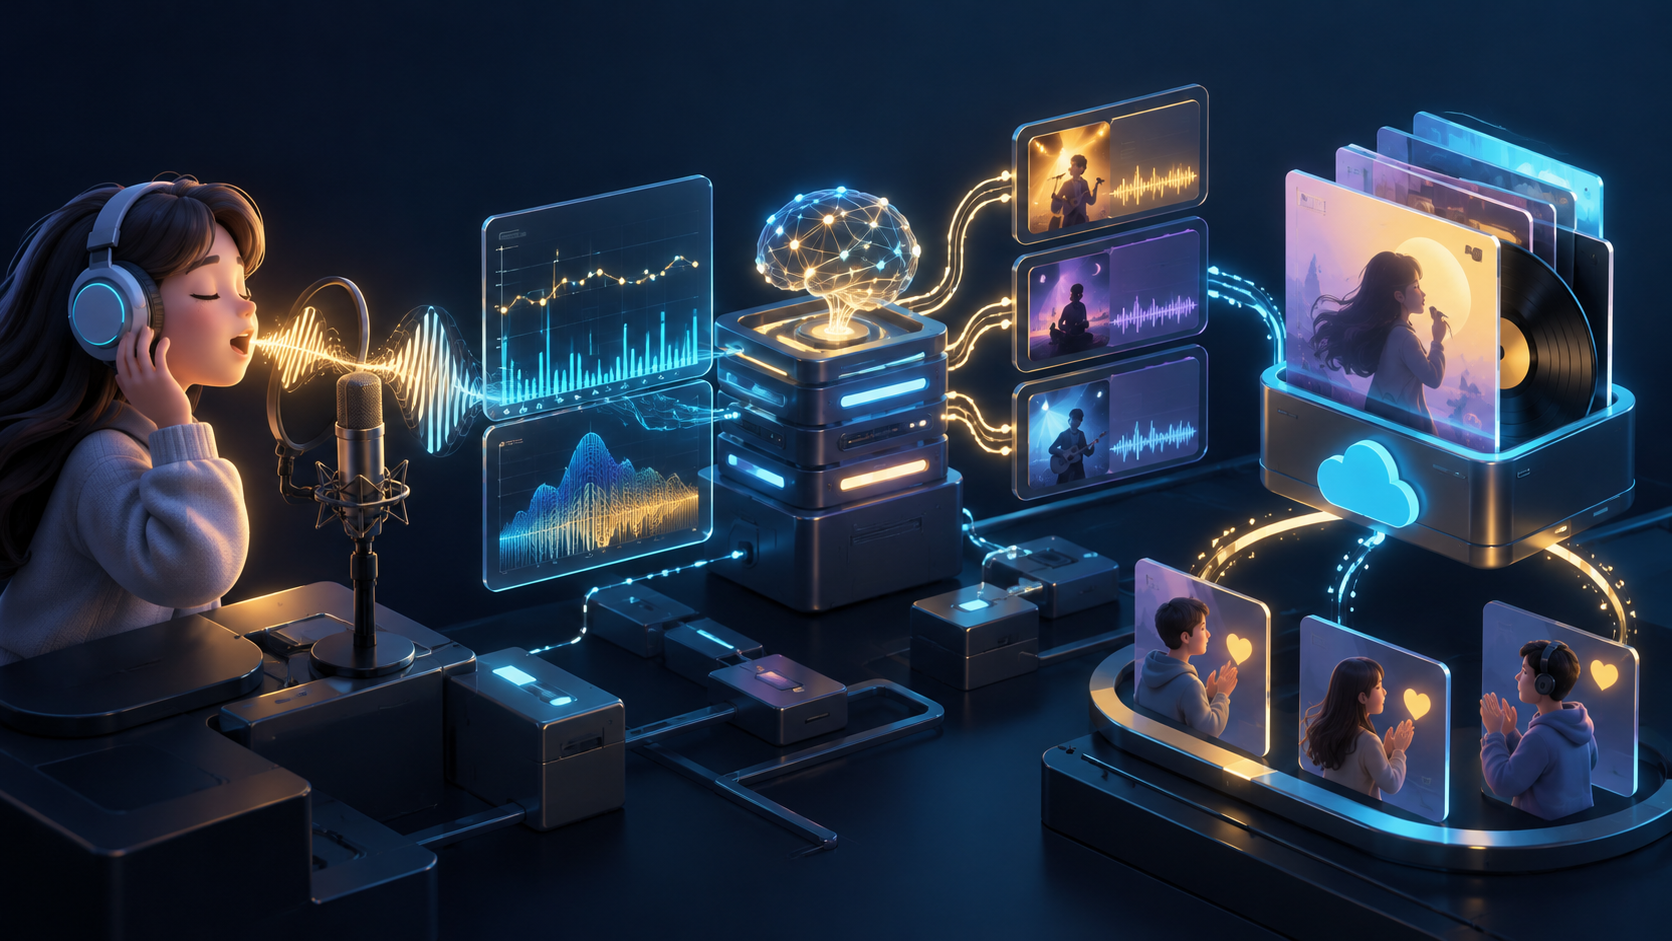
오락가락은 사용자의 음성을 분석해 음역대와 음색에 맞는 노래를 추천하고, 녹음을 모아 앨범도 만드는 음성 기반 음악 플랫폼이다. SSAFY 6인 팀이 5주 동안 만든 과정과 역할 분담을 다룬다.
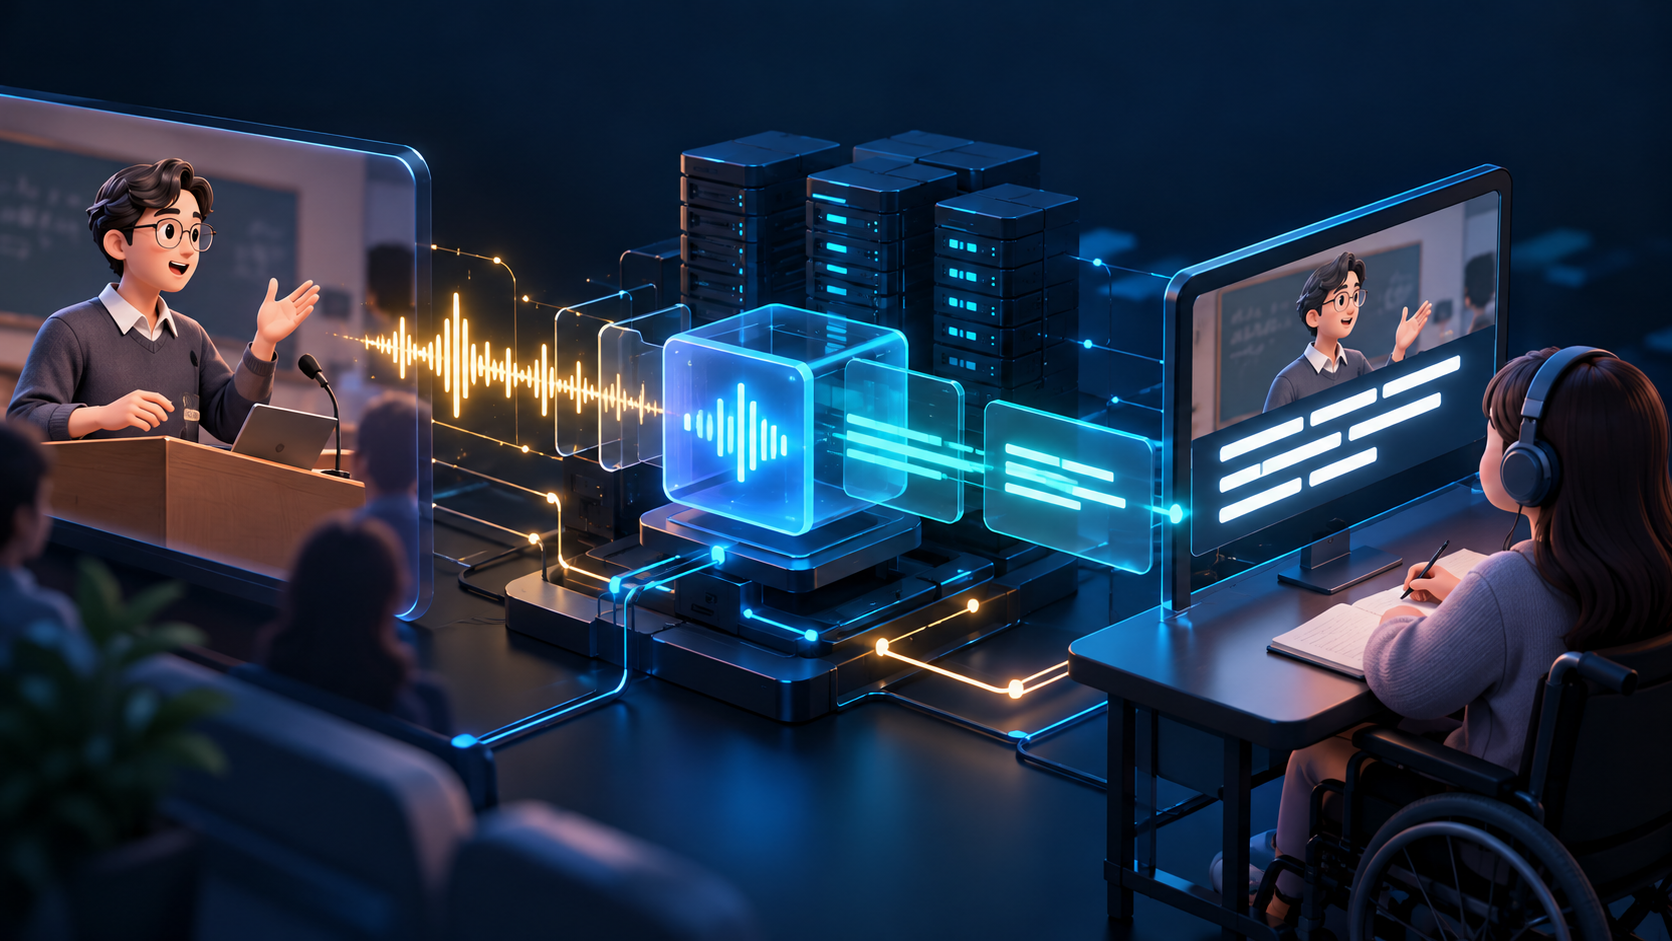
에듀밋은 온라인 강의 음성을 실시간 자막으로 바꿔 청각장애 학습자가 수업을 따라가게 돕는 교육 플랫폼이다. SSAFY 6인 팀으로 6주 동안 만들었고, 이후 혼자 이어받아 측정을 기준으로 성능과 운영 기반을 다시 세웠다.
원광대학교에서 진행된 AWS 모던 애플리케이션 교육에 참가하여 AWS JAM 실습으로 3등을 하고, IaC, 배포 전략, 멀티 클라우드 트렌드를 배운 이틀간의 교육 일지를 정리했습니다.